导语
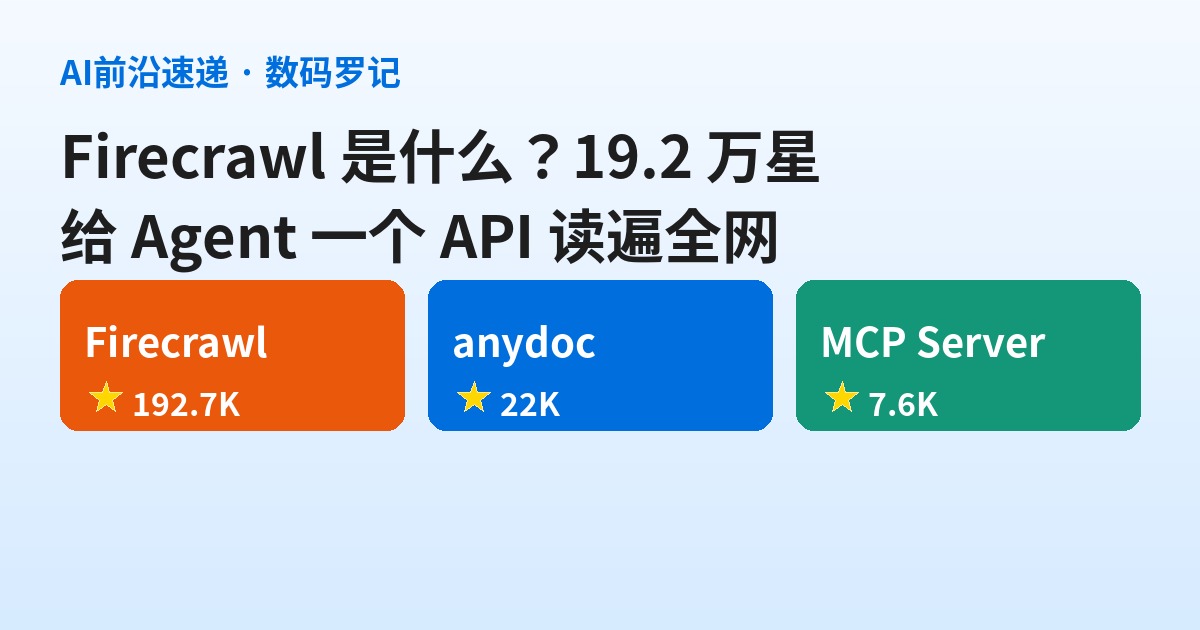
横向 Agent 平台系列写到「网页数据」这一挂,Apify 那期聊的是云上 Actor 市场,这一篇说另一家绕不过去的:Firecrawl。它的起点本来是个副产品——团队先做了文档问答产品 Mendable,做着做着发现全栈里最难的活是「把网页洗成干净数据」,干脆抽出来单干。2024 年 4 月仓库才建,两年半冲到 19.2 万星:去年 8 月 A 轮 1450 万美元,今年 9 月 B 轮又拿 7500 万美元,两轮合计 9120 万。官方现在的口径是:15 万家公司、150 万用户、50 亿次请求。一个「帮 Agent 读网页」的基础设施,在 Agent 时代直接长成了独角兽胚子。
项目介绍:一个 API,把脏网页洗成 Markdown
Firecrawl 干的活一句话说清:给它 URL 或关键词,它负责抓取、跑 JavaScript 渲染、过代理池绕反爬、去广告去标签,最后吐给你干净的 Markdown、结构化 JSON 或者截图。接口一套七个:Scrape 单页、Search 搜索带全文、Interact 抓下来还能点击填表、Crawl 整站、Map 秒列全站链接、Batch 批量几千页,最后是 Agent——直接说需求,它自己去搜去取。官方基准里,1,000 个 URL 的测试集覆盖率 96%,P95 延迟 3.4 秒。
生态里两块值得单说。一是 firecrawl-mcp-server(7.6K 星,MIT),把抓取和搜索挂进 Claude Code、Cursor 是一条命令的事;二是 anydoc,Rust 写的文档转 Markdown 库(2.2 万星),Word、PPT、Excel、PDF 等十四种格式一锅端,我们十月初写过一篇,它是 Firecrawl Parse 服务的底层。
模式是开源(AGPL-3.0)+ 云服务双轨:代码可以搬回家,云上帮你把代理、并发浏览器、持久化都运维掉。九月 B 轮时他们放出 Alexandria:把官方数据源、外部连接器、自家索引和实时网页打通,谁贡献数据给谁分钱——已经和 Wikimedia Enterprise 签了协议。从「抓公开网页」往「正版买数据」走了一步。

上手:先别注册,curl 一把
文档里第一步不花钱也不要 key:直接 POST https://api.firecrawl.dev/v2/scrape 丢个 URL,就回你 Markdown,限速低但足够验证链路。正式接入两条路:
- CLI:
npx -y firecrawl-cli@latest init --all --browser,一条命令装好命令行、浏览器登录,并给检测到的每个 coding agent 塞好技能,Claude Code、Cursor 之后自己知道什么时候该调 Firecrawl。 - MCP:把官方 MCP server 配进客户端,OAuth 登录,同样的效果。
想自己扛运力就自部署:docker compose 起,官方钉的版本 v2.11.162,API 默认落在 localhost:3002;注意本地 quickstart 把鉴权默认关了,别拿来当生产架构。
价格五档:免费档每月 1,000 积分、不要卡;Hobby 19 美元/月(年付 16);往上 Standard 83、Growth 333、Scale 599。计费按积分:1 页基础抓取 1 分,搜索每 10 条结果 2 分,Interact 每浏览器分钟 2 分,JSON、问答格式每页加 4 分,Monitor 每页每次 7 分。两个细节:抓取没拿到结果不扣费;但 403、404 这类错误页照扣 1 分。
实话
一、它卖的不是爬虫,是「读网页」的标准件。渲染、代理、反爬这些脏活全折进单价里,换来「任何网页丢进去都出干净数据」的可预期性。B 轮的钱要去买知识授权(Alexandria):抓取会被卷平,数据授权才有护城河,方向聪明——但这一步慢、吃谈判,短期还得靠按页收费撑着。
二、横向对照着挑:Apify 是云上 Actor 市场,重,但结构化数据和反爬兜底成熟;Scrapling、crawl4ai 走本地、自部署路线;browser-use 那一挂是整台浏览器全自动。Firecrawl 站中间:开源可搬回家,云上按页付费省运维。
三、账本要算。JSON 提取加 4 分、Monitor 7 分都是隐性大户,抓得狠烧得快;好在免费 1,000 分够把一个小流程从零跑通,先验证再充钱。
四、合规自己扛。公开数据、绕反爬、碰个人信息的边界,平台给能力不给豁免;Alexandria 想用「正版买数据」对冲一部分风险,但目前只覆盖协议内的源。
一句话总结:Firecrawl 押的是「网页是 Agent 时代的第一大数据源,而读网页会被标准化成一个 API」。想验证,领个免费 key 挂上 MCP,丢一个 URL 让 Claude Code 抓一次,比看十篇介绍都快。