百度千帆 AppBuilder 是什么?587 星的 AI 原生应用 SDK,BAT 三家里最后出场的横向 Agent 平台(基础篇)
横向 Agent 平台这条线,我们已经把阿里百炼、腾讯元器挨个盘过,BAT 里就差百度没讲。百度的答案叫「千帆」,而且这两年它悄悄改了名字——从「千帆大模型平台」变成「千帆·大模型服务及 Agent 开发平台」,光看名字就知道重心整个挪到 Agent 上了。它跟百炼、元器都不一样:元器零代码面向公众号,百炼拼模型全家桶,千帆真正拿得出手的是那套开源的 AppBuilder SDK,把百度攒了十几年的 OCR、文档解析这些「脏活」组件打包喂给大模型。这篇讲清它到底是什么、怎么上手、值不值得用。
它是什么
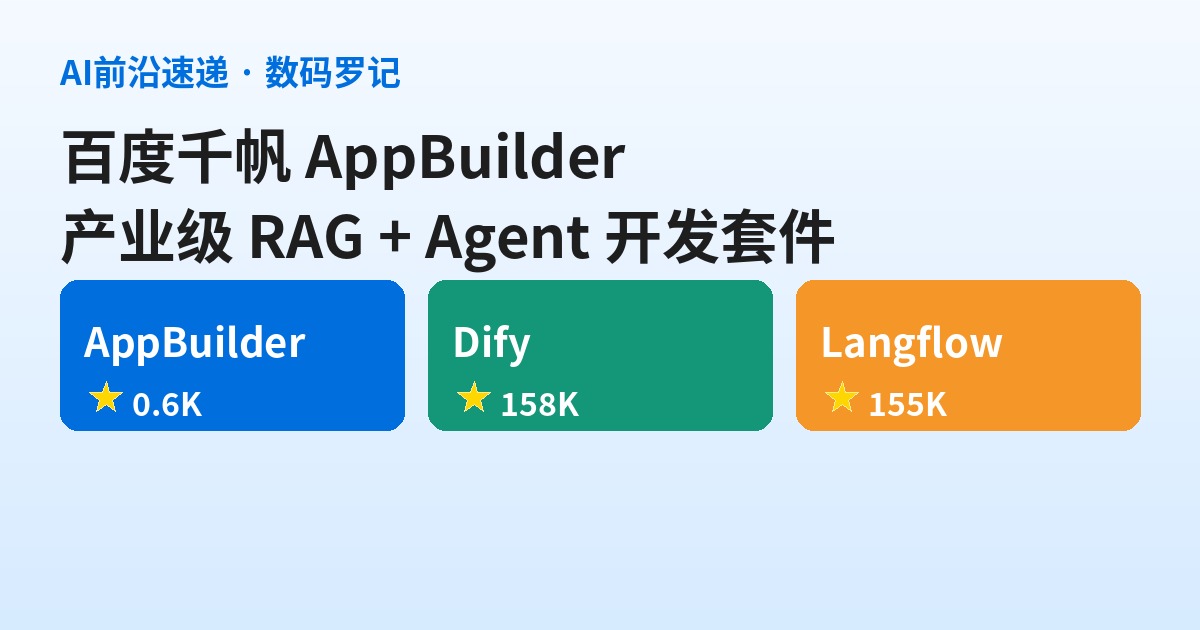
先分清两个东西。百度千帆 AppBuilder(appbuilder.cloud.baidu.com)是网页端的可视化 Agent / 应用搭建平台,跟 Dify、Coze 一个路子,拖拽编排、发布应用。真正开源的是配套的 AppBuilder-SDK(github.com/baidubce/app-builder),Apache-2.0 协议、Python 写的,PyPI 上叫 appbuilder-sdk,最新 1.1.5 版 2026 年 4 月 26 日发的。GitHub 上 587 星、142 fork——说实话这个星数在我们这个系列里排不上号,跟 Dify 的 15.8 万、Langflow 的 15.5 万差着两个数量级,但玩法不一样。
SDK 干四件事:
- 调用:大模型 + 40+ 个百度生态优质组件(OCR、表格抽取、文档矫正增强这些)+ 网页端发布的应用;
- 编排:
KnowledgeBase管知识库,Message/Component/AgentRuntime三级工作流抽象,能跟 LangChain、OpenAI 生态打通; - 监控:可视化 Tracing + 详细 DebugLog;
- 部署:
AgentRuntime一键部署成 Flask + gunicorn 的 API 服务,或者 Chainlit 的对话前端。
它最硬的部分是那条 RAG 全链路:文档解析(DocParser)、切片(DocSplitter)、向量化(Embedding)、索引(BaiduVectorDB / BES)、召回、答案生成,每一环都有现成组件,还带问答对挖掘、相似问生成、复杂 Query 判定分解、多轮改写这些高级组件。这套东西是百度做搜索和 OCR 攒下来的老本,别家真给不了。

上手路径
照官方文档走,一个下午能跑通:
pip install appbuilder-sdk;- 网页端注册拿
APPBUILDER_TOKEN,环境变量设好; - 想用网页端搭好的应用:
AppBuilderClient(app_id)直接调; - 想自己写工作流:
AgentRuntime编排,本地函数能联动端云组件; - 出口两条路:
appbuilder_bce_deploy发百度云出公网 API,或者 Chainlit 起个对话框调试。
模型这块,千帆背后以文心 ERNIE 系列为主,也接了 DeepSeek 这些第三方模型;推理接口做了 OpenAI 兼容,改个 base_url 就能用 OpenAI SDK 调,迁移成本不算高。
实话
真香的部分:组件质量是实打实的。中文文档、扫描件、复杂表格的解析,百度这套 OCR 比大多数开源方案稳,做产业级 RAG(合同、发票、标书)能省一大截预处理的力气。OpenAI 兼容接口也让它没那么封闭。
但坑得说清楚:
- 星数摆在这(587),社区生态基本没法跟 Dify 比,别指望有海量现成插件和教程;
- 重度绑定百度云,组件调用走百度的 API,免费额度用完就是按量计费,数据也全在百度云上,不能自托管;
- SDK 更新节奏偏慢:29 个 release,2026 年 4 月之后主仓基本没大动作,别指望它像 Dify 那样周更;
- 想要自托管、社区活跃的,还是去看 Dify 和 Langflow;想要零代码快速上线的,腾讯元器、阿里百炼 更省事。
一句话总结:千帆 AppBuilder 不是给个人开发者的玩具级选择,它是给那些已经在百度云上、要处理大量中文脏文档、想做产业级 RAG 的团队准备的。百度的搜索和 OCR 老本在这套 SDK 里是真能看见,但你得接受它封闭、更新慢、深度绑云的现实。