GitHub双响:OpenClaude把Claude Code变成“万能插座”,MiniMind用3块钱2小时手搓一个大模型
最近GitHub趋势榜有点意思:一边是人人想白嫖顶级Agent体验,一边是人人想搞懂大模型到底是怎么炼出来的。这期两个主角正好一左一右:一个教你“怎么用”,一个教你“怎么做”。
OpenClaude:3.3万星,任何模型都能跑出Claude味
一句话:OpenClaude是一个开源的编码Agent命令行工具,目标是“runs anywhere, uses anything”——在哪都能跑,接什么模型都行。
它解决的痛点很真实:Claude Code好用,但你被绑死在Anthropic的API和价格上。国产模型、本地Ollama、GitHub Models里的免费额度,想用就得换工具、换快捷键、重新学一遍。OpenClaude干脆把这一层抹平了:终端里敲openclaude,进去跑个/provider,按向导把OpenAI兼容接口、Gemini、GitHub Models、Codex OAuth、Ollama这些后端配好存成profile,之后提示词、工具调用、agents、MCP、斜杠命令、流式输出全是同一套手感。
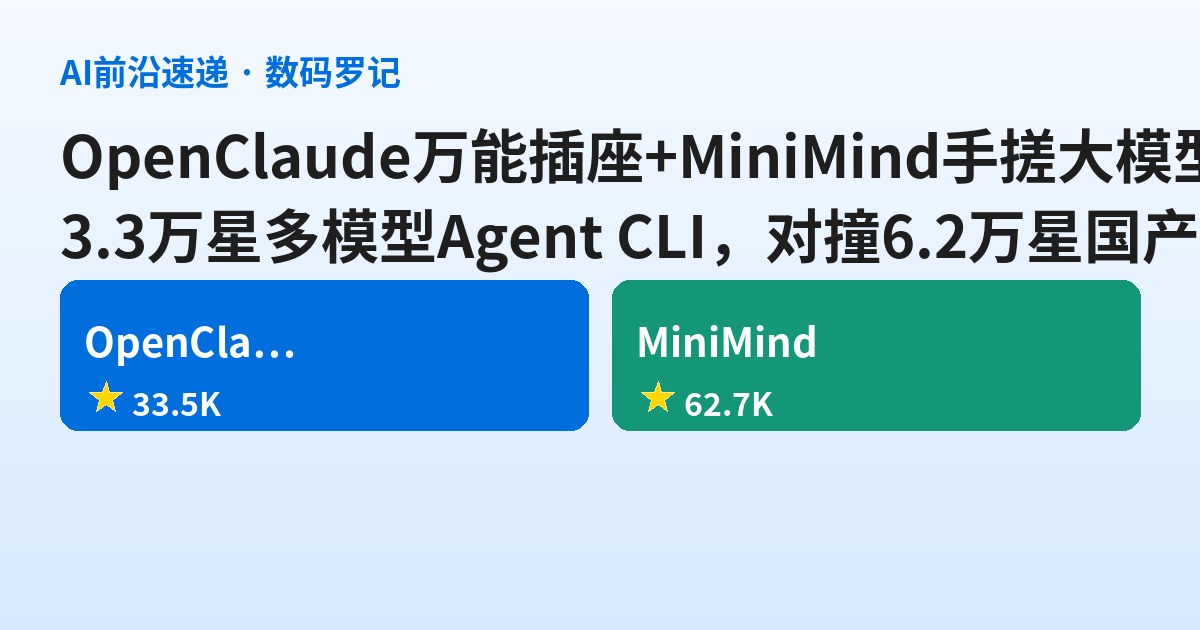
截至写稿时它有3.3万星、9千多fork,2026年4月才建仓,涨得飞快。装法也简单(要Node.js ≥22):
npm install -g @gitlawb/openclaude@latest
openclaude
里面还有个VS Code扩展负责启动集成和主题,以及一个很极客的彩蛋:像素风小人,每次你回车它就射一箭。玩笑归玩笑,核心是bash、文件工具、grep、glob、agents、tasks、MCP和联网工具全塞进了一个CLI,相当于把Claude Code那套工作流做成了“万能插座”。
跟之前介绍过的Cline那种编辑器内Agent比,OpenClaude更偏终端原生派;跟OpenManus那种通用Agent比,它更聚焦写代码这一件事。你要是在折腾本地模型落地,先从它下手成本最低。
MiniMind:6.2万星,国人3块钱2小时训出64M小模型
另一位是老熟人新爆火:MiniMind,作者jingyaogong,口号是“大道至简”——只花3块钱成本、2小时训练时间,从零训出一个64M参数的超小语言模型,体积大概只有GPT-3的两千七百分之一。
数字先摆出来:6.2万星、8千多fork,Python项目,2024年7月建仓,最近一周又涨了3千多星。火的原因不是模型有多强,而是它把大模型全链路摊开给你看:MoE、数据清洗、预训练、SFT、LoRA、RLHF(DPO)、RLAIF(PPO/GRPO/CISPO)、Tool Use、Agentic RL、自适应思考、模型蒸馏,全过程代码都在,而且核心算法全用PyTorch原生手写,不套高层抽象——就是让你看懂每一行在干什么。
注里写得很实在:“2小时”指的是SFT阶段在单张3090上的时间。言下之意:预训练另算,复现之前先看清README的配置表,别闭眼上机。项目还长出了MiniMind-V(视觉)、MiniMind-O(多模态Omni)、扩散语言模型和线性模型等分支,HuggingFace上也有全套权重合集,跟着教程走,一块消费级显卡就能跑完全程。
说点实话
这两个项目适合两类人。OpenClaude适合“想省钱又不想换手感”的人:手里有杂七杂八的API额度、或者本地跑着Ollama,用它统一入口最划算;但要记住,多后端意味着出问题先查provider配置,别一上来就怪工具。MiniMind适合“想真搞懂LLM”的人:别指望64M小模型替你写代码,它是教学模具——跑通一遍预训练到RLHF,你再去看Llama、Qwen的源码,眼睛就不再发直了。
一个帮你把Agent账单打下来,一个帮你把大模型的神秘感打下来。本周趋势榜上,这俩都值得一个star。
by 数码罗记·godsun.pro