这周 GitHub 上有两个项目干的是同一件事:把一摊大活拆成岗位,每个岗位塞一个 Agent,再用流程串起来。区别只在场景——一个在你自己的电脑上发版,一个在模拟盘上开单。体量都不是玩具级:gstack 138,235 星,TradingAgents 118,534 星,fork 都在两万上下。
gstack:YC 总裁把自己每天的 Claude Code 配置开源了
gstack 的作者是 Garry Tan,Y Combinator 总裁兼 CEO。2026 年 3 月建仓,现在 138,235 星、20,500 个 fork,MIT,TypeScript。
它没有玄学。一堆 Markdown 写的斜杠命令,加几个 Bun 编出来的小工具,把 Claude Code 从”一个聊天窗口”改成”一支工程队”。流程是 Think → Plan → Build → Review → Test → Ship → Reflect,每个斜杠命令对应一个岗位:
/office-hours用六个问题逼你重讲产品。你说”我要做个每日简报 App”,它会怼回来:”你描述的是私人幕僚长”,然后写一份设计文档给下游用。/plan-ceo-review砍范围,四种模式:扩张、选择性扩张、守范围、削减。/plan-eng-review锁架构、数据流、测试矩阵;/plan-design-review给每个设计维度打分,专门抓 AI 味。/review找死不了的 bug——过了 CI 但会在生产炸的那种,能自动改的直接改。/qa开真浏览器点流程、复现、写回归;/ship跑测试开 PR;/land-and-deploy合了等 CI、验生产健康。
真正让我多看两眼的是那些脏活命令。/cso 做安全审计,带 Docker 运行时,linux/amd64 和 linux/arm64 都有镜像,没 Docker 就退化成纯静态评估;/ios-qa 走 USB 的 CoreDevice 驱动真 iPhone,还能挂 tailnet 让远端 Agent 跑 iOS 测试,带设备级会话锁和审计日志;/pair-agent 把自己的浏览器分给别的 Agent 用——OpenClaw、Hermes、Codex、Cursor 都行,一个 Agent 一个 tab,token 隔离、限速、记谁点的。
安装两条命令:clone 到 ~/.claude/skills/gstack,跑 ./setup。要求 Bun 1.3.3 以上,低于这个版本 setup 直接拒装,理由是编译出来的工具能读项目里的 .env。这个细节比 README 里任何一句宣传都说明作者在想什么。
它还有个团队模式:仓库钉在 stable 频道(周一、周四发 tag,最快 72 小时一次),同事拉下来自动更新,没有 vendor 文件、没有版本漂移。代价是每台机器都得有 Node,钩子跑在 Node 上。
设计这块和 impeccable 是打通的:装了 impeccable 的引擎,/design-review 的机械问题会带着规则 id 过来。我们之前拆过 impeccable,那 62 条规则抓的就是同一批毛病,两边的口味对得上。
TradingAgents:把一次交易拆成一场辩论
TradingAgents 是 Tauric Research 的活,2024 年 12 月建仓,现在 118,534 星、22,663 个 fork,Apache-2.0,Python,最新 v0.7.1。
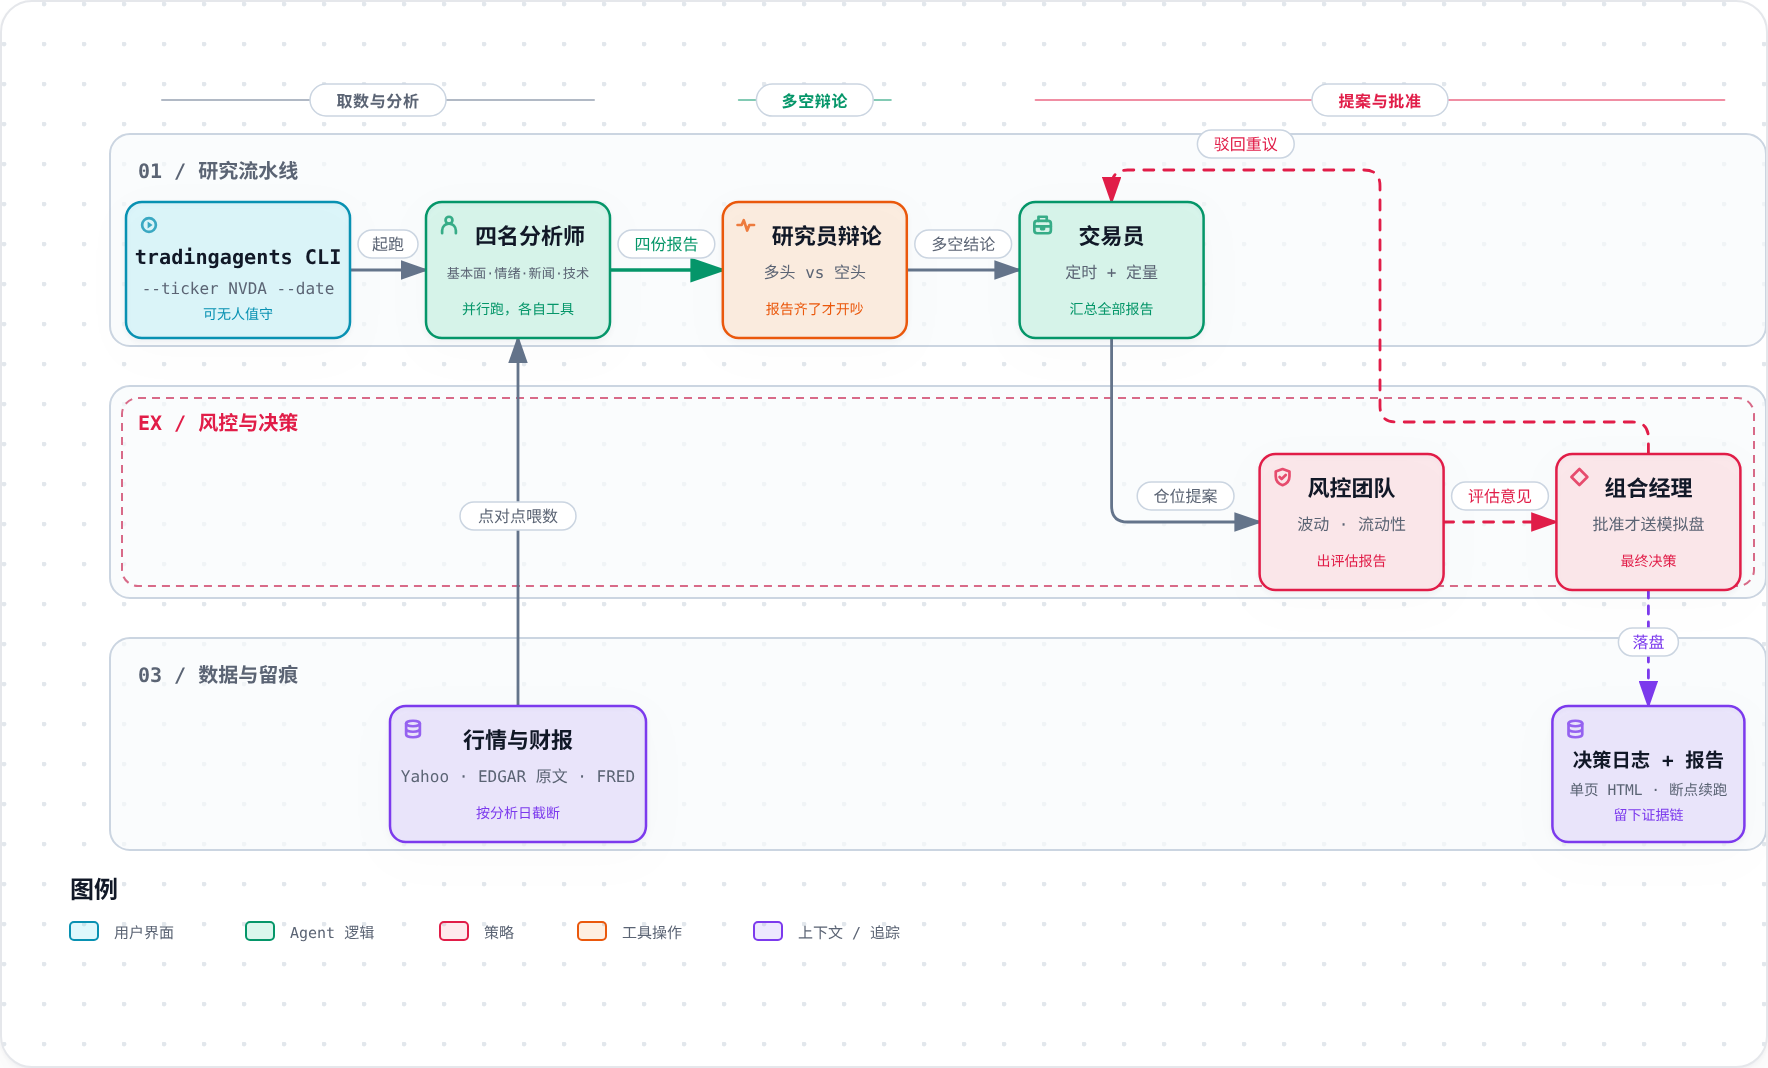
它照着真实交易公司的编制搭班子:四个分析师(基本面、情绪、新闻、技术指标)同时跑各自的工具,报告齐了才开始研究员辩论——一个多头、一个空头,结构化对吵;交易员拿着全部报告定时间和仓位;风控团队评估波动和流动性;最后由组合经理批准或驳回,批准了才送进模拟交易所。
编排用 LangGraph。这块我们写过基础篇,它干的就是把状态、节点、循环焊成一张有向图,天生适合这种”多角色 + 多轮”的流程。
值得抄的工程细节有三个。
一是 provider 铺得极宽。OpenAI、Gemini、Claude、Grok、DeepSeek、Qwen(国际和国内两套端点)、GLM、MiniMax、OpenRouter、Mistral、Groq、Kimi、NVIDIA NIM、Azure、Bedrock,本地还能接 Ollama、vLLM、LM Studio、llama.cpp。连 ChatGPT Plus/Pro 订阅都能直接用,代价是吃你订阅额度,而且不接受 temperature 和 max_tokens。
二是数据是点对点的。SEC EDGAR 读原始报表、FRED 拿宏观、Alpha Vantage 补行情、StockTwits 和 Reddit 抓情绪;回测只看分析日之前发布的文件,决策用之后第一个收盘价结算,长假按交易所日历结清。
三是留证据链。每次跑完存一页 HTML 报告,带本次设置;有决策记忆日志;支持断点续跑;CLI 可以纯 flag 跑,比如 --ticker NVDA --date 2026-09-23 --analysts market,news,fundamentals,扔进 cron 没人值守也行。
实话
两个项目最值钱的都不是模型,是流程和证据。gstack 每一步留文档,TradingAgents 每一步留报告和决策日志,出了事能倒查是哪一步拍错的。
但别当魔法看。gstack 四十来个命令,一个人日常能用上的大概五个,剩下的给团队和特定场景准备;它不提高模型智力,只约束流程,模型本身拉胯照样写出能跑但没法维护的代码。TradingAgents 更得说清楚:README 自己写着”仅供研究,不构成投资建议”。而且 0.7.1 修的正是”模型可能读到运行日之后的财报”——换句话说,之前的回测里存在偷看未来的口子,那些曲线里有多少是漏出来的,只有跑过的人自己知道。
判断这类项目我一般问三个问题:模型能不能换、数据是不是点对点、出错谁签字。gstack 三个都答得上来,因为它压根不替你签字,PR 还得你自己点 merge;TradingAgents 前两个答得漂亮,第三个它写在了免责声明里。
想省钱有个接法:TradingAgents 的 provider 可以指到本地的 Ollama 或 vLLM,日常盯盘用小模型跑,贵的模型只留到最后决策那一步。这套思路我们拿 1250 亿参数的模型在本地试过,瓶颈往往不在显卡,在磁盘和带宽。