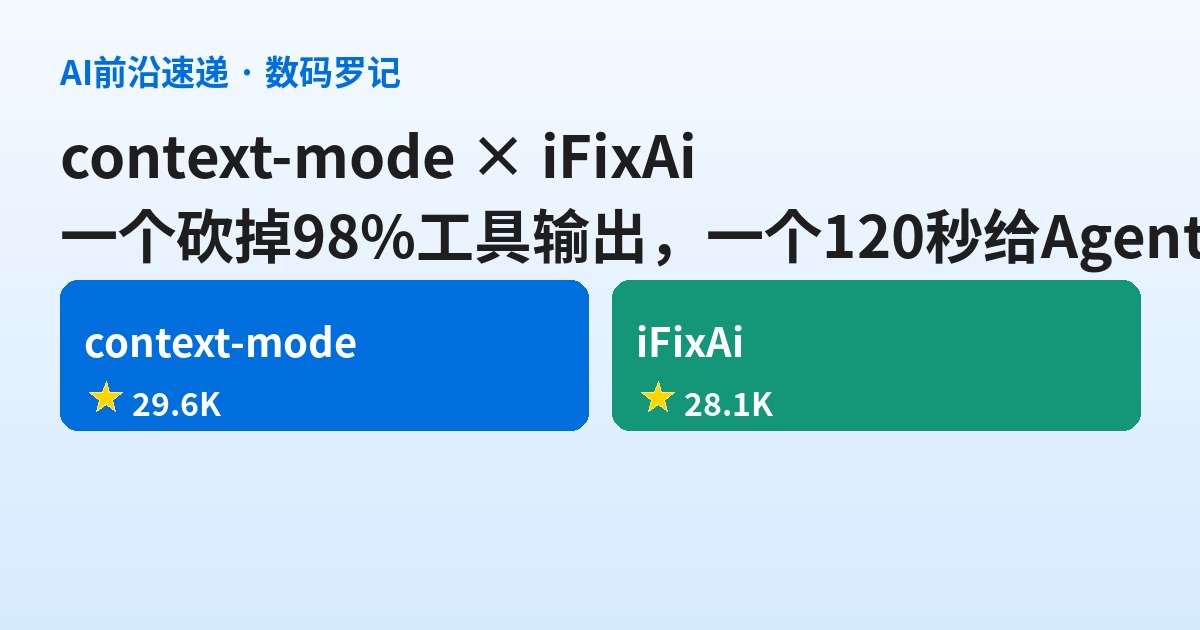
一个给Agent省上下文,一个给Agent做审计:2.96万星 context-mode、2.81万星 iFixAi 冲上GitHub周榜
上周 GitHub 榜单基本是「让 Agent 干新活」:拿逆向工程、画图纸、剪视频。这周风向变了,冲到周榜前列的两个项目,一个管嘴,一个管手——一个想办法别让上下文爆炸,一个想办法查清 Agent 到底干了什么。这两个问题,恰恰是 Agent 从玩具走向生产绕不过去的两道坎。
顺带说个数:上次写的 claude-mem 当时 9.98 万星,我去 GitHub API 上看了一眼,现在已经 10.09 万星了。记忆这条赛道是真有人在用,不是刷出来的。
context-mode:29,569 星,一周涨 3,297
mksglu/context-mode 是个 MCP server,TypeScript 写的,今年 2 月才建仓库,现在快 3 万星。它的 README 开头就摆了一组很扎心的数:一次 Playwright 快照 56 KB,20 条 GitHub issue 59 KB,一份访问日志 45 KB——你跟 Agent 聊 30 分钟,40% 的上下文就被这些原始输出吃掉了。
它给了四个对策,我觉得最狠的是前两个:
- 沙箱工具挡原始数据:工具返回不进上下文,进沙箱,模型只拿结果。官方给的账是 315 KB 变 5.4 KB,砍掉 98%。
- 会话连续性靠 SQLite + FTS5:每次改文件、跑 git、出错、你拍的板,都记进本地库。对话被压缩(compact)时不把旧数据倒回去,而是用 BM25 检索只捞相关的那几条。
- 用代码思考,别让模型读文件:47 次 Read() 等于 700 KB,改成一次
ctx_execute()跑段脚本,只console.log结果,3.6 KB。模型该写代码,不该当数据处理器。 - 不改模型的说话方式:很多项目靠暴力 prompt 逼模型少废话,README 直接引用 Moonshot 在 kimi-k2.5 上的结论——极简口吻 prompt 会拉低编码和推理跑分,所以它只管数据往哪放,不管模型怎么措辞。
装起来也简单:Claude Code 里 /plugin marketplace add mksglu/context-mode 就行,也可以 claude mcp add context-mode -- npx -y context-mode 先跑个纯 MCP 版试试。它支持 17 个客户端(含 OpenClaw 网关),注册 6 个沙箱工具 + 5 个管理工具,hooks 覆盖到 PreCompact。还有个可选状态栏,实时显示这次会话省了多少 token。
iFixAi:28,121 星,一周涨 5,796,本周 Python 榜第一
ifixai-ai/iFixAi 是 Python 项目,2026 年 4 月才建,Apache 2.0,Trendshift 给它挂的牌子是「本周 Python 仓库第一」。
它的立论很直接:现有的评测、红队、可观测性工具都在测 token 效率、延迟、提示注入这类技术指标,回答不了那个最关键的问题——Agent 是不是在按业务 KPI 和你的组织规矩干活? 官方说 120 秒内给答案。
底层引擎有 60 项检查,分 25 类,最后归到 5 个核心支柱打 A–F 分:编造(Fabrication)、操纵(Manipulation,权重 0.35,最重)、欺骗(Deception)、不可预测(Unpredictability)、不透明(Opacity)。默认只跑 10 项 essential 套件,--full-run 才全上 60 项——因为默认一次跑下来大约要调 850 次你的 Agent、820 次裁判模型,全量大约 5,500 + 4,700 次,这是要花钱的。
几个检查项挺对味:角色只能用被授权的工具(B01)、被话术忽悠也拿不到高于用户的权限(B08)、不给没权限的人跑破坏性操作(P01,这三条是强制项,缺了直接扣住总分)、抗提示注入(B12)、失败要报而不是装作成功(B16)。
跑法有三种:CLI 向导(pip install "ifixai[openai]" → ifixai setup → ifixai run)、全参数走 CI、或者装成插件/Skill 让 Agent 自己当操作员(uvx ifixai install --agents all 能一次给 Claude Code、Codex、Cursor、VS Code 等 10 家写进 /ifixai-skill)。最实用的一点是它能测你真实部署的 Agent:只要开着 OpenAI 兼容的 HTTP endpoint,加 --grounding sut 就当黑盒测,测的是你线上那套 system prompt + 工具 + 护栏,不是裸模型。评分还能换裁判——用别家厂商的模型给你家的 Agent 打分,避免自己出题自己答。
另外它带一个 --provider mock 模式,不联网不花钱就能把整条管线跑通,内置 fixture 是故意埋了雷的,B01 和 P01 必挂——第一次跑看到红别慌,那是它在演示失败长什么样。
实话
两个项目都把「Agent 的隐性成本」摆到了台面上:一个把 token 成本显性化,一个把风险成本显性化,方向都对,但各有各的小心思。context-mode 用的是 Elastic License 2.0,不是 OSI 认可的传统开源协议,你要拿去做托管服务得先读条款;它还带个云端 Insight 看板,团队版的味道出来了。iFixAi 引擎免费、60 项检查随便跑,但遥测默认是开的(不发代码不发分数,--no-telemetry 可关),商业版 Pro 把检查项加到 400 项并出合规报告,靠这个挣钱。
再提醒两句:context-mode 的省 token 效果取决于你的工具是否真往上下文里灌大数据,光聊天的场景收益有限;iFixAi 那 850 次 agent 调用 + 820 次 judge 调用是实打实的 API 账单,跑全量之前先算钱。装之前各自看一眼 harness 在不在支持列表里——一个认 17 个客户端,一个认 10 家 Agent,不在列表里就得自己接。