这篇继续围绕 Claude Code 展开,主题是「Claude Code 接手一个新项目,第一步应该让它看什么?」。前面几篇已经讲过安装、settings.json、-p 模式和 CLAUDE.md,这次往真实使用流程里再拆细一点。
别一上来就让它写代码
很多人第一次用 Claude Code 接手一个新项目,习惯直接抛一句「帮我加个登录功能」。结果生成的代码风格和现有项目完全不搭,目录也放错位置。问题不在模型,而在它根本还没「认识」这个项目。
所以我自己的做法是:新项目接入前,先让 Claude Code 做一次结构性阅读,再开始写任何业务代码。
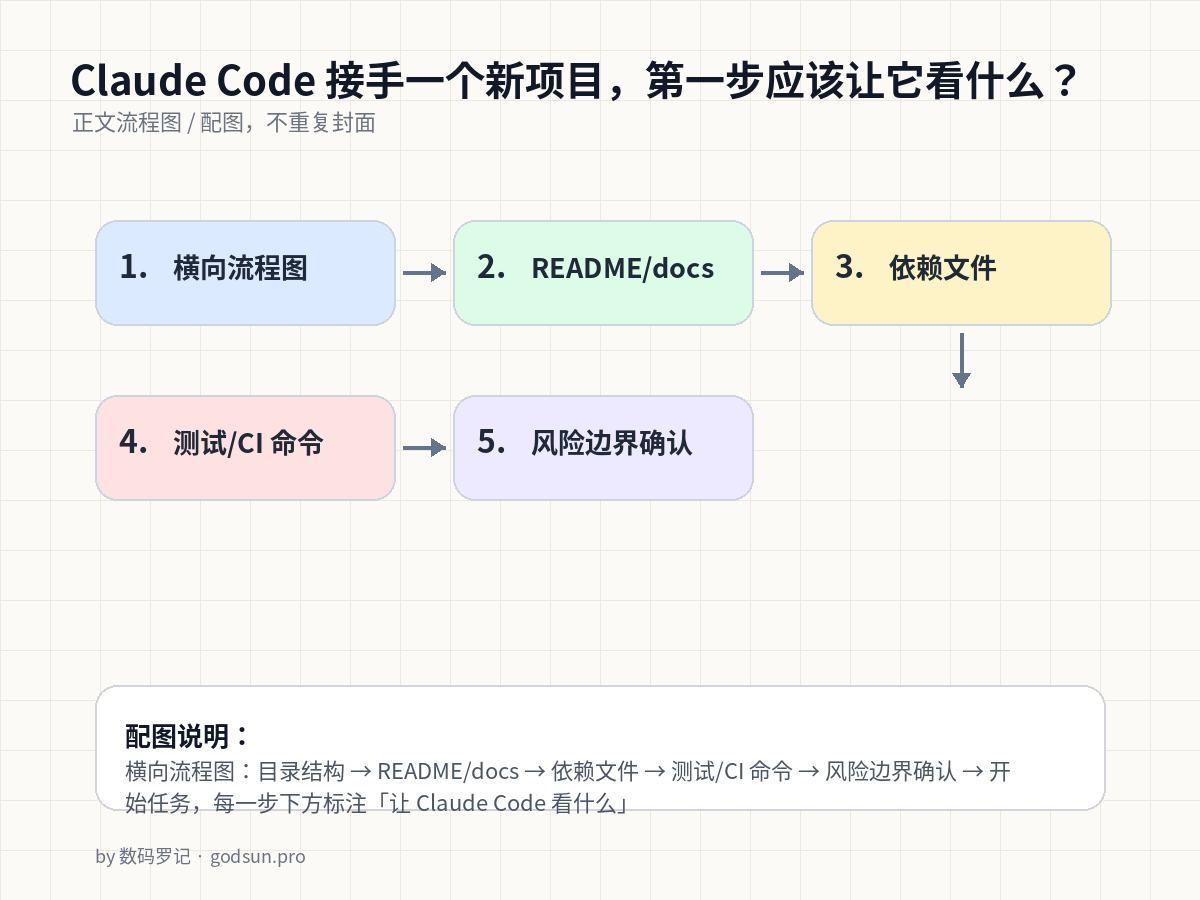
第一步:目录结构和定位
打开项目根目录,先让它跑一遍 ls 或 tree,对照说出:
- 这是前端、后端、还是全栈项目?
- 用的是哪个框架?
- 入口文件在哪里?
- 业务代码集中在哪个目录?
这一步的意义在于,让模型自己「描述」一遍它看到的项目,比你直接告诉它效果好。因为它说错了你能立刻发现。
第二步:README 和文档
README 是项目的「自述」,无论写得好不好都要先读。如果项目有 docs/、CONTRIBUTING.md、ARCHITECTURE.md 这类文件,也一并喂进去。
小白容易忽略一点:有时候 README 已经写明了启动命令和测试命令,让 Claude Code 提前看到,可以避免它后面去乱猜怎么跑项目。
第三步:依赖文件
package.json、requirements.txt、pyproject.toml、go.mod、Cargo.toml——根据语言不同,让它读对应的依赖清单。这一步可以让模型对技术栈有更准确的判断,比如:
- 用了 TypeScript 还是纯 JS
- 用的是 pytest 还是 unittest
- 用了哪些 ORM、Web 框架、构建工具
第四步:测试命令和 CI 配置
这一步常被跳过,但非常重要。让 Claude Code 看一眼 Makefile、package.json 的 scripts、.github/workflows/ 下的 CI 文件。
它能从中学到:
- 这个项目怎么跑测试
- 怎么跑 lint
- 怎么打包构建
以后你说「跑一下测试」,它就不会瞎写命令了。
第五步:明确风险边界
这一步是写给你自己的,不是写给模型的。在开始之前,先确认:
- 哪些目录是模型可以改的,哪些不能动(比如
migrations/、secrets/) - 是否允许它自动 commit
- 是否允许它执行删除类命令
这些信息建议写进 CLAUDE.md 或 settings.json 里,让规则常驻,而不是每次都口头说。
一份简洁的接入提示词
你可以参考这种顺序去问它:
- 「列一下当前目录结构,说说你判断这是什么项目」
- 「读 README 和 docs 目录,总结项目要点」
- 「读依赖文件,列出主要技术栈」
- 「找出测试命令、lint 命令、构建命令」
- 「我们这次任务是 X,你打算从哪个文件开始改?为什么?」
等它把这五步都答清楚,再让它动键盘。这样后面的代码质量会高很多,返工也会少。
小结
Claude Code 不是不能写新项目,而是先让它认识项目,再让它修改项目。第一步看什么,往往决定了后面写得对不对。
延伸阅读
如果你还没看前面的基础篇,可以先看《Claude Code 从零搭建》《settings.json 权限配置》《CLAUDE.md 项目规则》这几篇,再回来看本文会更顺。
小结
Claude Code 真正好用的地方,不是让它一次性替你完成所有事,而是把流程拆清楚:哪些让 AI 做,哪些必须人来确认,哪些结果要留下验证记录。这个习惯养成之后,它就更像一个靠谱的编程搭档。