这篇继续围绕 Claude Code 展开,主题是「用 Claude Code 排查 Bug:别一上来就让它改代码」。前面几篇已经讲过安装、settings.json、-p 模式和 CLAUDE.md,这次往真实使用流程里再拆细一点。
一个常见的反面例子
很多人遇到 Bug 的第一反应是:把报错信息扔给 Claude Code,然后说「帮我修一下」。模型也很「配合」,立刻改了一段代码。结果跑起来,原来的 Bug 没了,新的 Bug 出现了。
这种情况之所以常见,是因为我们让模型跳过了「理解问题」这一步,直接进入了「猜答案」阶段。
排查 Bug 的真正顺序
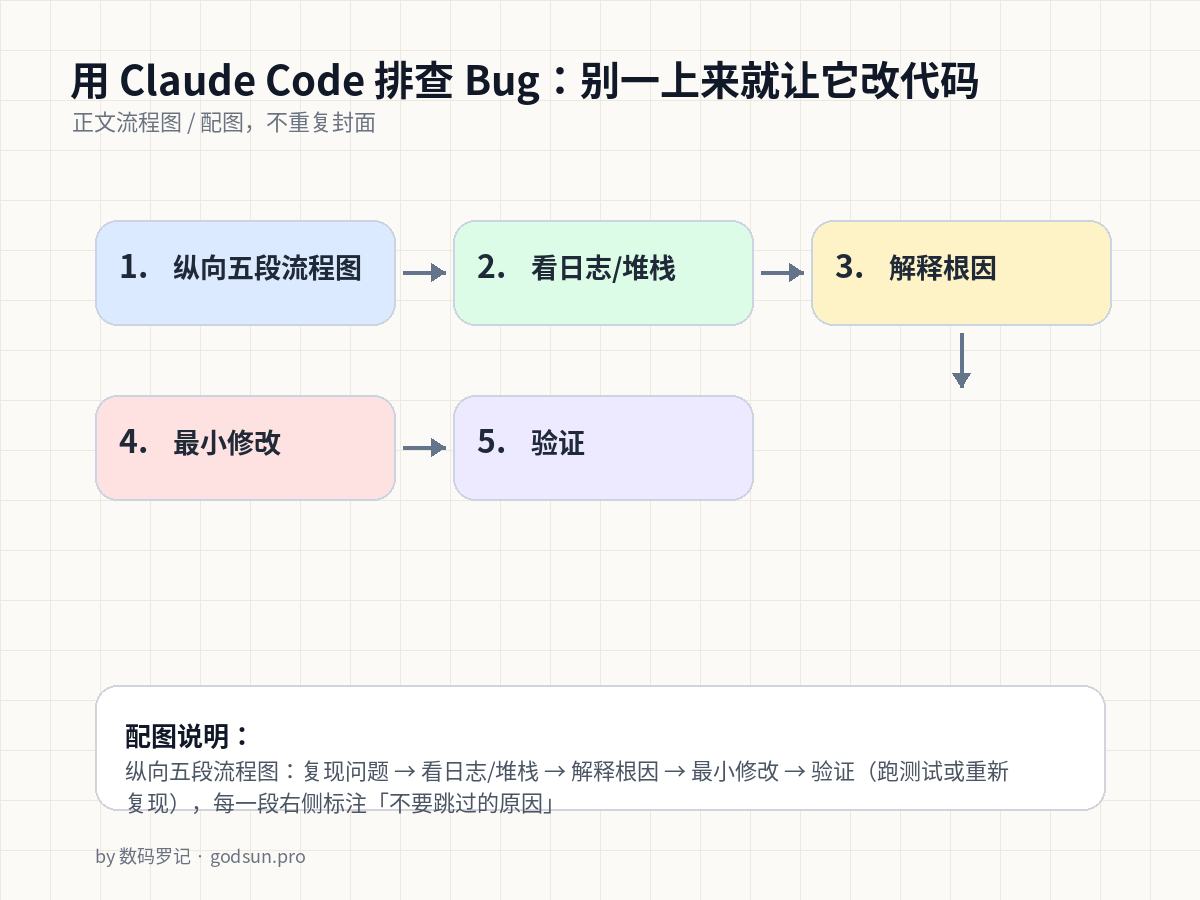
我自己排查 Bug 的顺序,和让 Claude Code 协助的顺序完全一致:
- 复现:先稳定地把问题重现一次
- 观察:看日志、堆栈、相关数据
- 定位:找到真正出错的位置
- 最小修改:用最小代价改掉它
- 验证:跑测试或重新复现,确认修好
这五步漏掉任何一步,都容易留下隐患。
第一步:让它复现,而不是猜原因
你可以这样问:
这是报错信息和触发场景,你先告诉我,怎么稳定地复现这个问题?
如果模型连复现方式都说不清楚,那它后面给的修复方案大概率也是猜的。复现不了,不要让它改代码,这条原则适用于人,也适用于 AI。
第二步:看日志和上下文
报错信息很重要,但不是全部。让 Claude Code 顺着调用栈往上看,找出:
- 出错的具体函数和行号
- 调用这个函数的上游是谁
- 出错时的参数值是什么
如果你的项目有日志文件,可以直接让它读一段相关日志。日志比报错堆栈给的信息往往更完整。
第三步:先解释原因,再写代码
这是我个人最在意的一步。让 Claude Code 在动代码之前,先用自然语言说清楚:
- Bug 的根本原因是什么
- 为什么这段代码会触发
- 你打算怎么改,改的影响范围有多大
这一步是「逼模型把思路讲出来」。它讲清楚了,你就能判断改的对不对;讲不清楚,那大概率它自己也没想明白。
第四步:最小修改,不要顺手「优化」
Claude Code 有个习惯:改 Bug 的时候顺便把周围代码「重构」一下。这个习惯在调试场景下非常危险,因为它会让 diff 变大,难以审查。
所以在调试任务里,我会明确告诉它:
只改导致 Bug 的那一处,其他代码不要动。
这样后面 git diff 看起来才清爽,也容易回滚。
第五步:验证修复
修完以后,跑测试或者手动复现一次。如果项目里没有相关测试,可以让 Claude Code 补一个最小回归测试,这样下次同样的问题就不会再悄悄出现。
一句话总结
Claude Code 排查 Bug 的关键不在「快」,而在「稳」。先复现、再分析、再最小修改,才是长期可靠的流程。你慢一点,它就会准一点。
延伸阅读
如果你还没看前面的基础篇,可以先看《Claude Code 从零搭建》《settings.json 权限配置》《CLAUDE.md 项目规则》这几篇,再回来看本文会更顺。
小结
Claude Code 真正好用的地方,不是让它一次性替你完成所有事,而是把流程拆清楚:哪些让 AI 做,哪些必须人来确认,哪些结果要留下验证记录。这个习惯养成之后,它就更像一个靠谱的编程搭档。