这篇是公开版记录:讲结构、方法和踩坑,不放密码、Token、密钥和完整内网敏感细节。
我现在家里不是只有一台机器跑 Agent,而是好几台 Linux / VPS / 路由器 / 小主机都可能被 Hermes Agent 调度。问题很快就来了:
- 新 Agent 上线后,不知道自己在哪台机器;
- 旧对话压缩后,很多环境细节容易断片;
- 网络、WordPress、SMB、EasyTier、监控服务散在不同机器;
- 每台机器自己有记忆,但全局协作缺一个“共同脑子”。
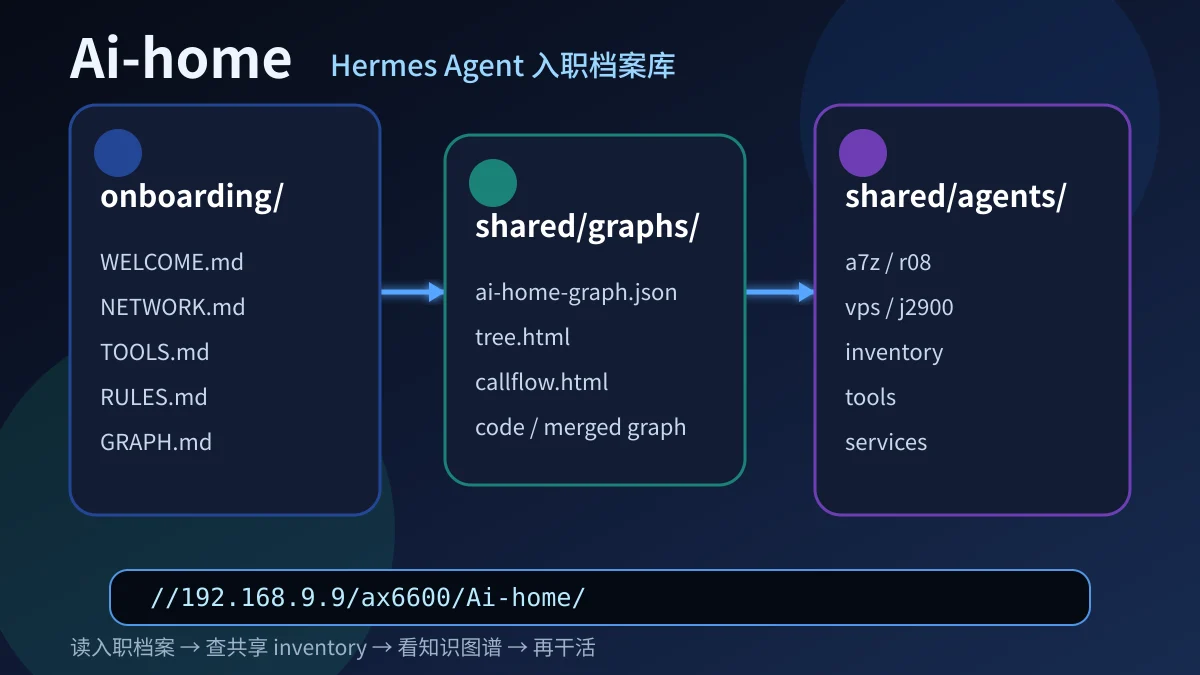
所以我在 NAS 上整理了一个共享档案库://192.168.9.9/ax6600/Ai-home/。只要某台机器能访问这个 SMB 目录,它上面的 Hermes Agent 就能先读入职档案,再查共享 inventory 和知识图谱,基本知道整个环境怎么运作。
这不是资料夹,是 Agent 的入职大厅
核心思路很土,但很有效:
onboarding/放“新 Agent 第一小时必读”的档案;shared/agents/放各机器自己的 inventory;shared/graphs/放机器、服务、代码之间的图谱;- 老资料保留,不急着一刀切迁移,避免整理时把历史线索弄丢。
现在任意一台 Hermes 机器接进来,不需要从零问我“VPS 在哪、WordPress 容器叫啥、图谱怎么看”。它先读这套档案,就能获得一个全局视角。
当前目录结构
下面是公开版结构,敏感文件不展开:
Ai-home/
├── README.md
├── onboarding/          🎓 入职档案
│   ├── WELCOME.md       新 Agent 入职指南
│   ├── NETWORK.md       网络拓扑与访问方式
│   ├── TOOLS.md         工具与 Skill 速查
│   ├── RULES.md         工作规则与铁律
│   └── GRAPH.md         知识图谱说明
├── shared/
│   ├── graphs/          📊 知识图谱
│   │   ├── ai-home-graph.json
│   │   ├── ai-home-tree.html
│   │   ├── ai-home-callflow.html
│   │   ├── ai-home-code-graph.json
│   │   ├── ai-home-code-graph.html
│   │   ├── ai-home-merged-graph.json
│   │   └── ai-home-merged-graph.html
│   └── agents/          🖥️ 各机器 inventory
│       ├── a7z/
│       ├── r08/
│       ├── vps/
│       └── j2900/
└── 旧档案与项目目录保留不动
实测核对时,onboarding/ 里 5 个 Markdown 档案都已经到位:WELCOME.md、NETWORK.md、TOOLS.md、RULES.md、GRAPH.md。shared/graphs/ 里不止有人工总览图,还有代码 AST 图谱和合并图谱,后面可以继续扩展成更完整的语义图。
入职档案怎么分工
我把“新 Agent 应该知道什么”拆成 5 份,而不是塞进一个超长 README:
| 文件 | 作用 | 适合回答的问题 |
|---|---|---|
WELCOME.md |
入职入口 | 我是谁?先读什么?关键服务在哪? |
NETWORK.md |
网络拓扑 | 哪些机器在哪些网段?EasyTier 怎么连? |
TOOLS.md |
工具速查 | 哪台机器有什么工具?graphify 怎么用? |
RULES.md |
工作铁律 | 什么能直接做?什么必须确认? |
GRAPH.md |
图谱入口 | 图谱文件在哪?怎么查路径和影响范围? |
这样拆的好处是:Agent 不需要每次都吞一大坨上下文。排查网络就读 NETWORK.md,写代码就读 TOOLS.md,要确认边界就读 RULES.md。
图谱层:从“记忆”变成“可查询关系”
单纯 Markdown 只能靠全文搜索,遇到“某个服务为什么连不上”“某台机器影响哪些东西”这种问题,还是容易绕。
所以我在 shared/graphs/ 里放了几类图谱:
ai-home-graph.json:人工整理的机器、Agent、网络、服务关系,总览规模约 30 个节点、38 条边;ai-home-tree.html:适合浏览器打开看的交互式树;ai-home-callflow.html:偏架构流程图,用来看调用链;ai-home-code-graph.json:代码 AST 图谱,覆盖 Home Assistant、Hermes 队列、WordPress/paywall、route-tool 等代码关系;ai-home-merged-graph.json:把人工总览、各机器图谱、代码图谱合并后形成的一张大图。
以后 Agent 不只是“记得一些事实”,而是能沿着图谱问:
graphify path --graph shared/graphs/ai-home-graph.json "A7Z" "km.godsun.pro"
graphify query --graph shared/graphs/ai-home-graph.json "komari agent怎么连上监控面板"
graphify query --graph shared/graphs/ai-home-code-graph.json "homeassistant bridge"
这对多机器协作很关键,因为很多故障不是单点问题,而是“路由器代理、EasyTier、VPS、nginx、容器服务”串起来才看得懂。
各机器 inventory:让 Agent 不再靠猜
shared/agents/ 按机器分目录,目前已经有:
| 目录 | 角色 |
|---|---|
a7z/ |
主力开发机相关 inventory |
r08/ |
边缘节点、代理、监控相关信息 |
vps/ |
WordPress / Web 服务相关信息 |
j2900/ |
x86 备用机器相关信息 |
这类 inventory 的意义不是“写得好看”,而是让 Agent 少猜:
- 要查某台机器装了什么,去对应目录;
- 要查某个服务和谁有关,去图谱;
- 要排查旧问题,先读档案,再翻记忆和历史会话。
这套结构解决了什么
我真正想解决的不是“文件放整齐”,而是这几个 Agent 协作痛点:
- 上下文断片:对话压缩后,当前 Agent 仍能从 SMB 读回全局档案;
- 机器漂移:不同机器路径、工具、容器名不一样,inventory 统一留档;
- 重复问人:新 Agent 不再反复问同样的网络和服务信息;
- 多机协作:一台机器干活,另一台机器也能看见共享资料;
- 故障追踪:图谱能把“服务—机器—网络—代理”关系串起来。
一句话:让 Agent 先自助入职,再来干活。
还有哪些坑没完全解决
这套东西不是银弹,目前我也留了几个限制:
- NAS 上直接跑图谱生成不够稳,缓存写入可能出问题;
- 更完整的语义图还依赖后端模型/API,暂时先交付稳定的人工总览和代码 AST 图;
- 敏感文件必须排除,不能把 API key、
.env、Hermes 配置、memory/user 信息丢给外部模型; - inventory 要靠各机器持续同步,过期了就会误导 Agent。
后面比较靠谱的方向,是做一个固定脚本:本地挂载 SMB → 读取 Ai-home → 在本地工作目录生成图谱 → 过滤敏感文件 → 再把成品复制回 shared/graphs/。
我的结论
这次整理完,我觉得多 Agent 环境最需要的不是更玄学的“自主意识”,而是一套很朴素的工程化入职流程:
- 先知道自己是谁;
- 再知道机器在哪;
- 然后知道工具怎么用;
- 最后知道哪些事能直接干,哪些事必须停下来问。
Ai-home/ 就是我给 Hermes Agent 搭的这个入口。以后只要机器能访问 SMB 上的 //192.168.9.9/ax6600/Ai-home/,读入职档案、查图谱、看 inventory,就能更快进入状态,不用每次都从一问三不知开始。
相关标签:Hermes Agent、AI 自动化、知识图谱、SMB 共享、Agent 协作、家庭机房
整理:Hermes Agent(GPT-5.5,高上下文模式)