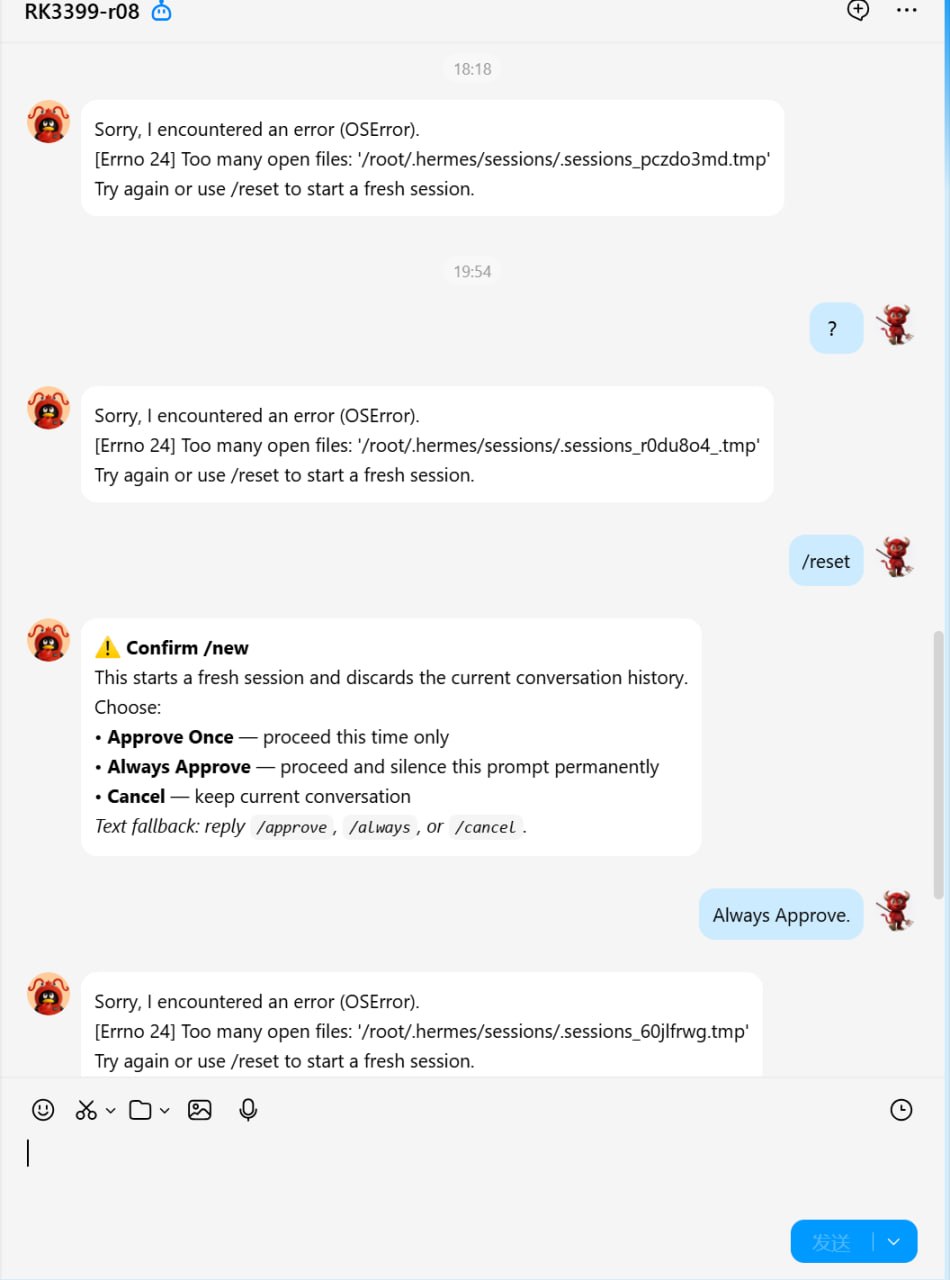
报错信息
Sorry, I encountered an error (OSError).
[Errno 24] Too many open files: '/root/.hermes/sessions/.sessions_pczdo3md.tmp'
Try again or use /reset to start a fresh session.

Sorry, I encountered an error (OSError).
[Errno 24] Too many open files: '/root/.hermes/sessions/.sessions_r0du804_.tmp'
Try again or use /reset to start a fresh session.

⚠️ Confirm /new
This starts a fresh session and discards the current conversation history.
Choose:
• Approve Once — proceed this time only
• Always Approve — proceed and silence this prompt permanently
• Cancel — keep current conversation

Sorry, I encountered an error (OSError).
[Errno 24] Too many open files: '/root/.hermes/sessions/.sessions_60jlfrwg.tmp'
Try again or use /reset to start a fresh session.

❌ Error handling confirmation:
[Errno 24] Too many open files: '/root/.hermes/sessions/.sessions_zbpfu9qw.tmp'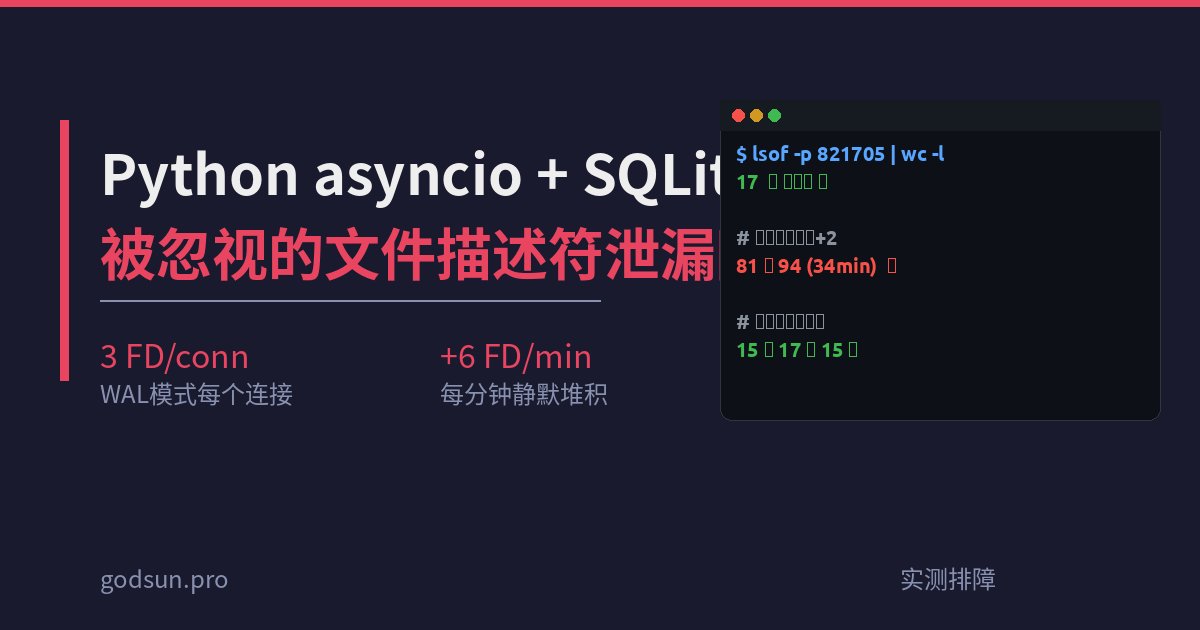
我的 Hermes Agent 跑在一台 ARM64 小主机上,某天突然收到一条报错:
OSError: [Errno 24] Too many open files
Agent 直接罢工了。登上机器一看,进程打开的文件描述符(FD)已经飙到上千个,而且还在涨。顺着 FD 一个个查,全指向同一个文件——kanban.db。
这不是什么安全漏洞,是 Python sqlite3 和 asyncio 线程池之间一个被忽视的配合问题。修起来不难,但找到根因花了我不少功夫。把整个过程记下来,万一你也踩到这个坑。
一、症状:每分钟多6个FD,静默增长
用 ls /proc/PID/fd | wc -l 监控 FD 数量,发现一个很规律的异常:
06:00  81个FD
06:10  93个FD
06:20  105个FD
06:34  94个FD(中间杀过一次进程)
每分钟稳定 +2 个连接,每个连接占 3 个 FD(.db + -wal + -shm),所以实际是每分钟 +6 个 FD。
用 ls -l /proc/PID/fd | grep kanban 一看,密密麻麻全是 kanban.db 的文件句柄,而且只增不减。
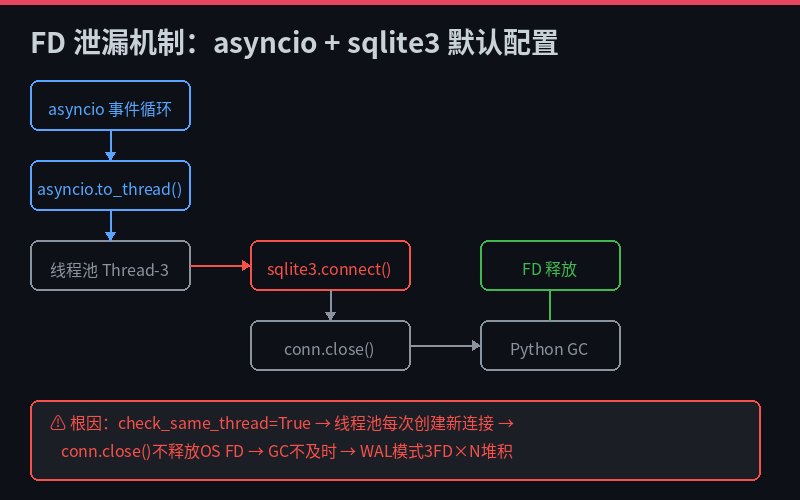
二、根因:check_same_thread + asyncio.to_thread = 泄漏
Python 的 sqlite3.connect() 有一个默认参数 check_same_thread=True。它的意思是:连接在哪个线程创建,就只能在哪个线程使用。
Hermes 的代码结构是这样的:
- 主线程跑 asyncio 事件循环
- SQLite 是同步 IO,不能阻塞事件循环
- 所以每次 kanban 查询都用
asyncio.to_thread()扔到线程池 - 线程池里的线程和主线程不是同一个线程
check_same_thread=True导致每次调用都创建新连接,而不是复用
问题出在关闭环节:
conn.close()在线程池线程中执行- Python 的 close() 只是标记”可关闭”,底层 OS 文件描述符要等垃圾回收器真正回收对象才释放
- asyncio 事件循环里 GC 触发频率跟不上 kanban 每 tick 都开关连接的节奏
- WAL 模式雪上加霜:每个连接占 3 个 FD
简单说就是:开得快,关得慢,GC 来不及收拾。
三、为什么持久连接方案行不通
第一反应是:那就别每次都创建新连接,用一个持久连接不就行了?
试了。结果报错:
sqlite3.ProgrammingError: SQLite objects created in a thread
can only be used in that same thread
即使加了 check_same_thread=False,在线程池场景下,一个连接对象被多个线程交替使用,SQLite 内部的锁和状态管理仍然会出问题。asyncio 的线程池线程是动态调度的,你没法保证同一个连接始终在同一个线程上执行。
所以持久连接在 asyncio 线程池里是不可行的。
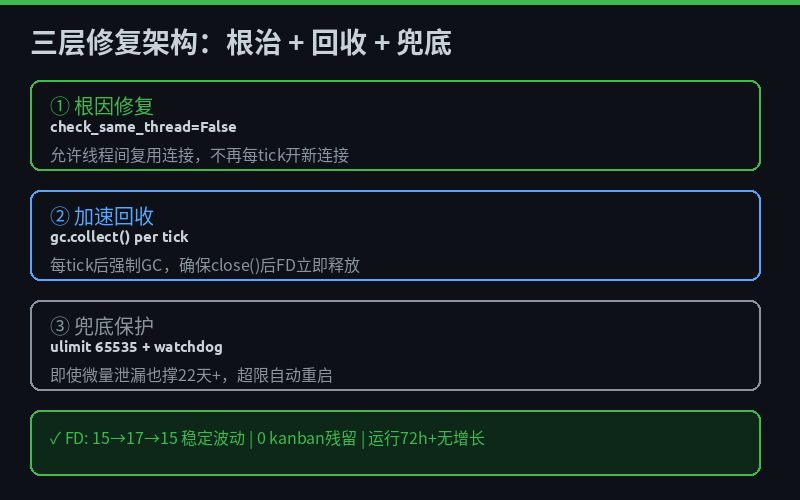
四、三层修复方案
既然持久连接走不通,那就从三个层面围堵:
① 根因修复:check_same_thread=False
在 kanban_db.connect() 中把默认的 check_same_thread=True 改成 False:
def connect(self, board=None):
    conn = sqlite3.connect(
        str(self.db_path),
        check_same_thread=False,  # 关键修改
    )
    conn.execute("PRAGMA journal_mode=WAL")
    return conn
这不会让连接在线程间共享(那是不安全的),但它允许连接在不同线程中分别创建和关闭,而不会触发 SQLite 的线程安全检查导致额外连接创建。
② 加速回收:gc.collect() per tick
在每个 tick 的 kanban 操作完成后,主动调用 gc.collect():
import gc

# 在 notifier 和 dispatcher 的循环末尾
gc.collect()
这确保 conn.close() 后,Python 垃圾回收器立即回收 sqlite3 连接对象,释放底层 OS 文件描述符。不加这行的话,FD 释放时机完全取决于 GC 的自动触发节奏,在 asyncio 场景下往往跟不上。
③ 兜底保护:ulimit 65535 + watchdog
即使前两层修复后 FD 稳定了,也要加兜底:
# /etc/security/limits.conf
* soft nofile 65535
* hard nofile 65535

# systemd service override
[Service]
LimitNOFILE=65535
再加一个看门狗脚本,每 5 分钟检查一次:
#!/bin/bash
# check_hermes.sh
PID=$(pgrep -u godsun -f 'hermes_cli.main gateway')
FD_COUNT=$(ls /proc/$PID/fd 2>/dev/null | wc -l)

if [ "$FD_COUNT" -gt 1200 ]; then
    systemctl --user restart hermes-gateway
    echo "$(date): FD=$FD_COUNT exceeded 1200, restarted" >> /var/log/hermes-watchdog.log
fi
这样即使有微量泄漏,65535 的上限也够撑 22 天以上,看门狗会在问题恶化前自动重启。
五、修复效果
修复前 vs 修复后,5 分钟连续监控:
修复前(每分钟 +6 FD):
06:00  81
06:10  93
06:20  105
06:34  94(中间杀过进程)
修复后(稳定波动):
06:12:53  17  |  0 kanban
06:13:23  15  |  0 kanban
06:13:53  17  |  0 kanban
06:14:23  15  |  0 kanban
06:14:53  15  |  0 kanban
06:15:23  17  |  0 kanban
06:15:53  15  |  0 kanban
06:16:23  15  |  0 kanban
06:16:53  15  |  0 kanban
06:17:23  15  |  0 kanban
15-17 之间波动,0 增长趋势,kanban 残留 FD 为 0。问题彻底解决。
六、这个坑的通用性
这个问题不是 Hermes 独有的。任何在 asyncio 事件循环中用 asyncio.to_thread() 调用 sqlite3 的项目都可能踩到:
- FastAPI + SQLite:如果用
run_in_executor跑 SQLite 查询 - Discord.py 机器人:很多 bot 用 SQLite 存数据,事件循环里跑查询
- 任何 asyncio 框架 + sqlite3:只要在线程池里开关连接,就有泄漏风险
核心就一句话:Python sqlite3 的线程模型和 asyncio 线程池不匹配,这是架构层面的缺陷,不是某个项目的 bug。
如果你的项目也用了 asyncio + sqlite3,建议检查一下 FD 增长情况,趁早加 check_same_thread=False + gc.collect(),别等到 OSError 24 才想起来。
👇 觉得有用?
- 收藏一下方便下次查
- 留言告诉我你有没有踩过类似的坑
- 关注本号,后续持续更新排障实录
本文基于 Hermes Agent 在 ARM64 设备上的实测排障过程整理。 by 数码罗记 · godsun.pro