
这两天看 Agent 工具时,我又碰到一个挺适合放进工具箱的项目:Scrapling。它不是聊天机器人,也不是另一个大模型框架,而是一个专门做网页采集的 Python 工具。
如果把 AI Agent 比成一个会干活的数字助手,那网页采集能力其实很关键。很多任务不是靠模型凭空想出来的,而是要先去网页上读资料、抓文档、看项目 README、整理更新记录,然后再分析、总结、写文章。Scrapling 补的就是这一块能力。
我已经在当前 Hermes Agent 环境里实际装了一遍,基础解析和普通网页抓取都跑通了。本文就按实测结果聊聊:Scrapling 是什么、它适合 AI Agent 做什么、和普通 requests/BeautifulSoup 有什么区别,以及后面值不值得接进 Hermes 的工具链。
一、Scrapling 是什么?
Scrapling 是一个 Python Web Scraping 框架,GitHub 项目地址是:
https://github.com/D4Vinci/Scrapling
我查看仓库时,它的主要信息是:
- 语言:Python
- License:BSD-3-Clause
- PyPI 包名:scrapling
- 版本:0.4.8
- 定位:自适应 Web Scraping 框架
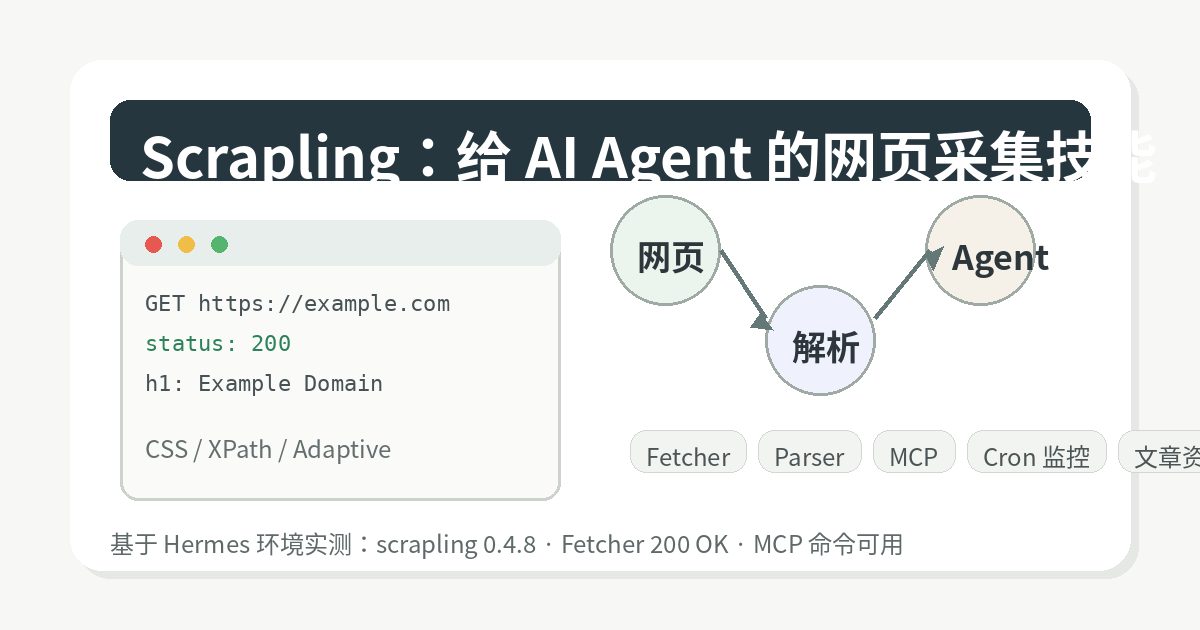
- 支持 Parser、Fetcher、Spider、CLI、MCP 模式
用普通话说,它就是一个更现代的网页采集工具。以前我们经常用 requests 拉 HTML,再用 BeautifulSoup 或 lxml 解析。Scrapling 则把“抓取、解析、选择器、自适应、爬虫框架、Agent 接入”这些东西做成了一套。
二、为什么 Agent 需要网页采集技能?
很多人刚开始用 Agent,会以为它只是“更聪明的聊天机器人”。但真正用起来以后,会发现 Agent 的价值不只是回答问题,而是能主动做任务。
比如我平时让 Hermes 帮我做这些事:
- 查看一个 GitHub 项目值不值得研究;
- 整理开源项目的 README、安装方式和使用场景;
- 把项目分析写成 WordPress 文章;
- 监控某些项目有没有新版本;
- 抓公开文档里的关键参数;
- 把网页资料整理成自己的 Agent 技能库。
这些任务都有一个共同点:模型本身不是第一步,第一步是“把网页资料可靠地读下来”。如果网页内容拿不准,后面的总结、判断、写文章都会出问题。
所以对 Agent 来说,网页采集不是可有可无的小功能,而是它接触外部世界的一种基础能力。
三、我在 Hermes 环境里的安装和测试
我没有直接全量安装浏览器依赖,而是先在当前 Hermes 的 Python venv 里安装了 Scrapling 的 AI 版本:
pip install "scrapling[ai]"安装后检查到的版本是:
scrapling 0.4.8然后我做了两个最小测试。
1. 本地 HTML 解析测试
用 Scrapling 的 parser 解析一段本地 HTML,提取标题和链接,结果正常:
from scrapling.parser import Adaptor

html = '<html><body><h1>Scrapling 测试</h1><div class="item"><a href="/a">第一个链接</a></div></body></html>'
p = Adaptor(html, url='https://example.com')

print(p.css('h1::text').get())
print(p.css('.item a::attr(href)').get())
输出结果:
Scrapling 测试
/a
2. 普通网页抓取测试
再用 Fetcher 抓取 example.com,返回 200,标题也能正常提取:
from scrapling.fetchers import Fetcher

p = Fetcher.get('https://example.com', timeout=15)
print(p.status)
print(p.css('h1::text').get())
实测结果:
status: 200
title: Example Domain
CLI 也可用,能看到 extract、install、mcp、shell 这些子命令。MCP 依赖也能正常 import。不过我这次没有跑 scrapling install 下载浏览器依赖,因为那一步会明显增加系统环境改动。后面如果要测试 DynamicFetcher 或 StealthyFetcher,再单独装浏览器组件更稳。
四、Scrapling 相比普通抓网页强在哪里?
Scrapling 最吸引我的点不是“能不能抓网页”,而是它把网页采集做得更接近 Agent 工作流。
1. 选择器更顺手
它支持 CSS selector,写法和前端开发里常见的选择器很接近。比如抓标题、链接、列表项,不需要额外绕一大圈。
2. 有自适应解析思路
项目 README 里重点提到 adaptive parser,也就是页面结构变动后,Scrapling 可以尝试重新定位目标元素。这一点对长期任务很实用。
比如你做一个定时任务,每天抓某个项目的下载按钮、版本号、价格表。如果对方页面小改版,传统选择器可能直接失效。自适应能力就有机会减少维护成本。当然这类能力也不是万能的,实际效果还要看具体页面结构,不能神化。
3. 有 Fetcher 和 Spider 体系
Scrapling 不只是一个 parser,它还有 Fetcher、AsyncFetcher、DynamicFetcher、StealthyFetcher,以及 Spider 框架。简单页面可以轻量抓,复杂任务可以扩展成完整爬虫。
对个人站长和 Agent 用户来说,这个分层挺重要:平时查资料用轻量 Fetcher 就够了,不要每次都开浏览器;遇到动态页面时,再考虑浏览器模式。
4. 支持 MCP,方便给 Agent 接入
Scrapling CLI 里已经有 scrapling mcp 命令。这意味着它不是单纯给人写脚本用,也考虑了给 AI Agent 当工具服务器。
后面如果要接入 Hermes,可以有两种路线:
- 简单路线:Hermes 通过 Python 脚本直接调用 Scrapling;
- 标准路线:把 Scrapling MCP server 配到 Hermes MCP 工具里。
我个人更倾向先用第一种,确认稳定后再做 MCP 化。原因很简单:先解决实际任务,再追求架构漂亮。
五、它适合放在 Agent 的哪些场景里?
按我现在的使用习惯,Scrapling 最适合这几类场景。
1. GitHub 项目资料整理
比如丢给 Agent 一个项目地址,让它抓 README、安装命令、文档链接、release 信息,再整理成一篇“这个项目能不能用”的文章。这个流程和我现在做 Agent 教学站很贴合。
2. 文档站点转知识库
很多开源项目的文档分散在多个页面里。Scrapling 可以负责把公开文档抓下来,Agent 再负责清洗、摘要、归档成技能或知识库。
3. 定时监控网页变化
比如监控某个工具有没有新版本、价格页有没有变化、下载链接是否失效。这个可以和 Hermes 的 cron 任务组合起来。
4. 写文章前的资料采集
我现在写 Agent 相关内容,最怕的是空泛。一个项目到底支不支持 MCP?安装命令是什么?Python 版本要求是多少?这些都应该先从公开资料里抓出来,再写进文章。Scrapling 能让这个步骤更稳定。
六、使用时要注意什么?
虽然 Scrapling 的能力很强,但我不建议把它包装成“万能反爬神器”。对个人站和 Agent 工具来说,更健康的用法应该是:
- 采集公开网页资料;
- 尊重网站 robots 和服务条款;
- 不要抓登录后的隐私数据;
- 不要高频压测别人的网站;
- 能用官方 API 时优先用 API;
- 文章写作时避免夸大“绕过反爬”这类说法。
这也是我后面在本站写 Agent 工具时会坚持的口径:工具是用来提高效率的,不是用来搞破坏的。
七、我的结论:值得加入 Agent 工具箱
这次初步测试后,我觉得 Scrapling 值得加入 Agent 工具箱。它不是替代 Hermes 自带 web/browser 工具,而是补一个更专业的网页采集层。
简单理解:
- Hermes 负责调度任务、调用工具、写文章、发 WordPress;
- Scrapling 负责把网页资料更稳定地抓下来;
- Memory/Skills 负责把经验沉淀下来;
- Cron 负责长期监控和自动执行。
这几块合在一起,才像一个真正能干活的 Agent 系统,而不是单纯聊天。
后面我会继续测试两个方向:一个是 Scrapling 的 MCP server 怎么接进 Hermes;另一个是用它做一个“GitHub 项目自动采集 → 文章草稿 → WordPress 发布”的小流程。如果跑顺了,这会变成本站后续整理 Agent 项目的基础技能之一。
下期可以继续聊:怎么把 Scrapling MCP 接进 Hermes Agent,让网页采集变成一个可调用工具。
如果你也在搭自己的 Agent,可以先收藏这个项目。对“让 Agent 自己读网页、整理资料、写文章”这类需求来说,它确实有用。