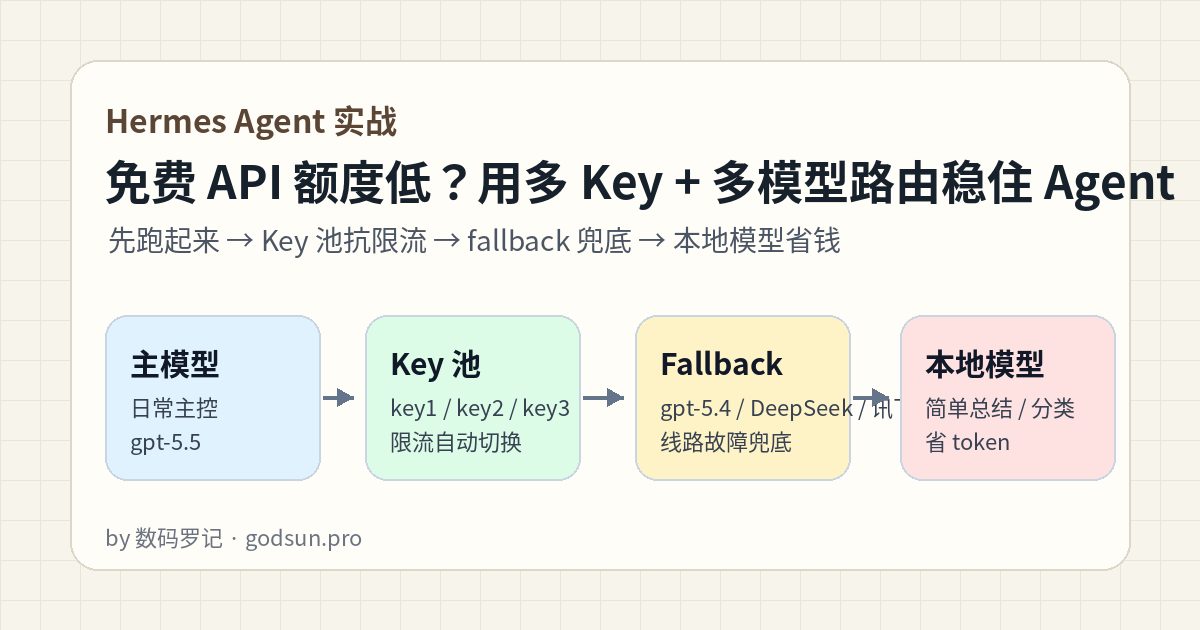
很多小白第一次搭 AI Agent,最容易卡住的不是安装,而是模型。教程里一句“填一个 API Key”,看起来很简单,实际用起来会遇到三个问题:免费模型额度低、某个接口突然限流、低端模型逻辑跟不上。最后表现出来就是:Agent 说着说着断了,或者工具调用到一半乱掉。
我自己最近给 Hermes Agent 配模型时,就遇到过类似情况。单个免费 API 能跑,但额度窗口、限流和中转压力一来,稳定性就不够。所以这篇不讲玄学,直接写一个小白能理解的实战方案:先让 Agent 用一个能跑的模型启动起来,再用多 key、多模型、多线路做兜底。
如果你连 Hermes Agent 第一次怎么安装、怎么填第一个模型都还没做,可以先看本站这篇基础教程:《从零安装 Hermes Agent:让 AI 真正开始帮你干活》。本文默认你已经能把 Hermes 跑起来了。

一、先说结论:不要一上来就追求“最强模型”
很多人第一次搭 Agent,会有一个误区:觉得只要接上最强模型,Agent 就能稳。实际不是这样。Agent 和普通聊天不同,它会查文件、调用终端、访问网页、生成文章、执行多步任务。模型再强,如果 API 不稳定,任务执行到一半断掉,也一样很难用。
我现在更推荐小白按这个顺序来:
- 第一步:先配置一个能正常回复、能调用工具的模型,让 Agent 先跑起来。
- 第二步:给同一个模型准备 2-3 个 API Key,遇到限流可以自动换。
- 第三步:再准备 1-2 个不同供应商的备用模型,防止整条线路出问题。
- 第四步:本地有条件的话,把简单任务丢给本地模型,复杂任务再用在线 API。
这套思路不炫技,但非常适合小白。因为你不是在做模型评测,而是在做一个长期能干活的 Agent。
二、什么是多模型路由?用人话解释
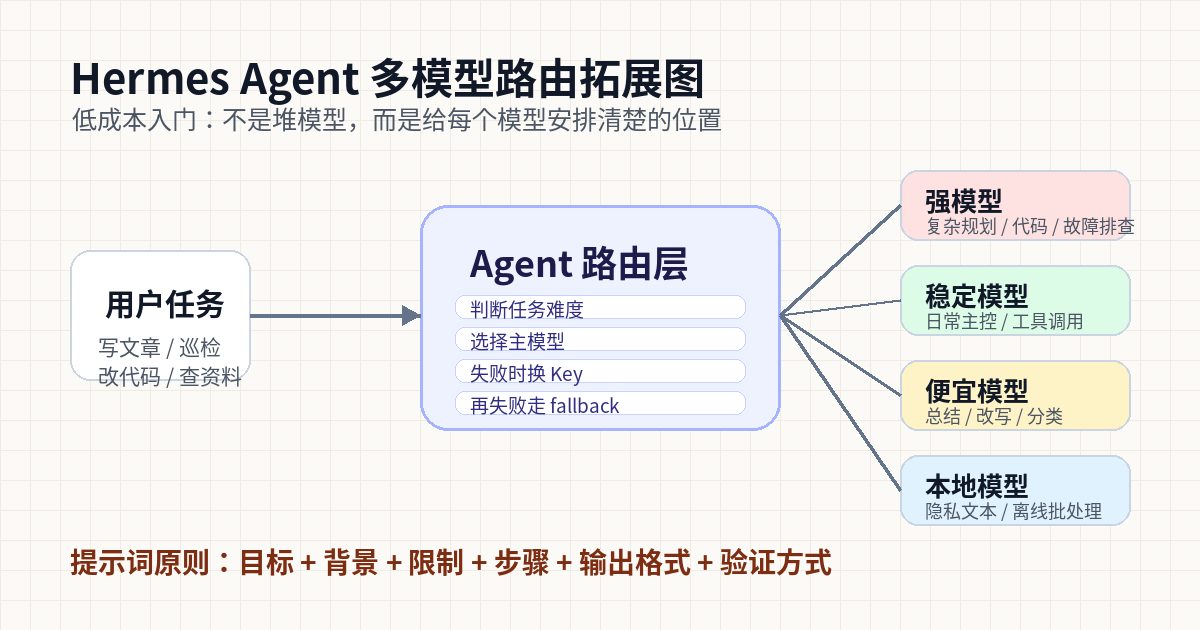
多模型路由,可以理解成给 Agent 配一个“用人规则”。不是每件事都找同一个模型,而是按任务难度和稳定性要求分配。
- 便宜模型:适合改标题、总结日志、分类文章、简单问答。
- 稳定模型:适合日常主控,负责理解你的指令和安排工具调用。
- 强模型:适合写复杂代码、排查疑难故障、长文章结构设计。
- 本地模型:适合隐私内容、低成本批处理、简单离线任务。
如果用 Hermes Agent 举例,最朴素的路由就是:
日常主控:gpt-5.5 / Claude / DeepSeek 这类能力较强的模型
备用同类:同模型多 API Key 轮换,防止免费额度低、请求限流
降级备用:gpt-5.4、DeepSeek、讯飞等可用线路
本地补位:llama.cpp 跑 7B/8B/14B 量化模型,做简单任务
这里的重点不是模型名字,而是位置:主模型负责质量,备用 key 负责抗限流,备用供应商负责抗故障,本地模型负责省钱。
三、免费模型 API 额度低,为什么要多 Key 轮换?
免费 API 或试用额度最大的问题不是“不能用”,而是不适合把所有任务都压在一个 Key 上。有些平台是按分钟限流,有些是按天限额,有些中转线路高峰期会慢。你只配一个 Key,Agent 一旦遇到 429、额度不足、超时,就只能停在那里。
多 Key 轮换的好处很直接:
- 第一个 Key 限流了,自动试第二个。
- 第二个也不行,再试第三个。
- 同一个模型能力不变,Agent 不容易因为换模型而风格大变。
- 免费额度可以分散使用,适合小白低成本入门。
我这次实战就是给 Hermes 配了类似的三 key 池:主 key、备用 key、第二备用 key。不是为了“白嫖到底”,而是为了避免写文章、巡检网站、处理服务器时突然断掉。对入门用户来说,2 个 Key 已经够用,3 个 Key 会更稳一点。
四、推荐小白怎么组合模型路由?
不要一上来配十几个模型。模型越多,配置越乱,出了问题越难排查。小白按下面三个档位来就够了。
1. 最小可用版:1 个模型 + 1 个 Key
适合刚入门,只想确认 Hermes 能不能跑起来。
- 一个 OpenAI 兼容 API
- 一个可用模型
- 一个 API Key
这个阶段不要纠结多模型,先让 Agent 正常回复、能用工具、能完成一个小任务。比如让它读取一个文件、生成一篇短文、检查网站状态。
2. 稳定入门版:1 个主模型 + 2-3 个 Key
这是我最推荐的入门配置。模型不变,只增加 Key 池。
主模型:gpt-5.5 / DeepSeek / 其他 OpenAI 兼容模型
Key 池:key1、key2、key3
用途:日常聊天、写文章、调用工具、服务器巡检
这个方案的优点是:Agent 的能力和输出风格比较一致,遇到限流时也有缓冲。免费额度低的平台,尤其适合这样配。
3. 长期实战版:主模型 + Key 池 + fallback 模型 + 本地模型
如果你准备让 Agent 长期在线,比如接 Telegram、QQBot、每天巡检网站、自动写文章,那就要上这一档。
第一层:主模型,同模型 2-3 个 Key 轮换
第二层:备用模型,例如 gpt-5.4 / DeepSeek / 讯飞
第三层:本地模型,处理简单总结、分类、隐私文本
第四层:强模型,只在复杂代码、疑难故障时使用
这就是我现在更偏向的路线:日常任务省钱,关键任务保质量,线路异常能自动降级。
五、Hermes Agent 里可以怎么理解这个配置?
Hermes 的配置核心有三块:主模型、Credential Pool、fallback。小白不用一开始就看懂所有字段,先理解它们分别干什么。
- 主模型:Agent 默认先用谁。
- Credential Pool:同一个 provider 下有多个 Key,按优先级轮换。
- fallback providers:当前 provider 不行时,换另一个供应商或模型。
可以用下面这个简化配置理解,不建议新手直接复制生产环境,真实 API Key 要放好,不要公开到文章、GitHub 或聊天记录里。
model:
  provider: freemodel
  default: gpt-5.5
  providers:
    freemodel:
      type: openai
      base_url: https://你的-openai兼容接口/v1
      api_key: sk-你的主key
      model: gpt-5.5

fallback_providers:
  - provider: freemodel54
    model: gpt-5.4
  - provider: deepseek
    model: deepseek-v4-pro
  - provider: xunfei
    model: astron-code-latest
多 Key 池通常在 Hermes 的认证/凭据池里管理。思路是同一个 provider 下放多个 key,优先级从 0、1、2 往后排。当第一个 key 出现限流、超额、认证失败或连接异常时,Hermes 可以尝试后面的 key 或 fallback provider。
如果你是小白,不建议第一次就手改复杂 JSON。更稳妥的路线是:先通过 Hermes 的模型配置向导或配置篇跑通一个模型,再看进阶篇添加 Key 池。本文的重点是理解“为什么要这样配”。
补充:OpenAI 兼容接口在 OpenClaw、Hermes、Codex 里怎么填?
这次我又验证了一次 OpenAI 兼容接口的接法。很多人卡在“模型列表不出来”,其实不是模型不能用,而是把地址填错了,或者把 API Key 当成模型名填进去了。
为了避免误导,我这里不用自己的加速/VIP 通道做截图演示,统一用官方普通通道写法举例。真实使用时把域名和 Key 换成你自己的即可,文章和截图里不要暴露完整 token。
1. OpenClaw 里添加模型
OpenClaw 如果选择 OpenAI Compatible / OpenAI 兼容供应商,通常这样填:
Provider 类型:OpenAI Compatible
Base URL:https://api.freemodel.dev/v1
API Key:fe_oa_**************(不要公开完整 Key)
Model:gpt-5.5
这里最容易错的是 Base URL。一般只填到 /v1,不要填完整的 /v1/chat/completions。因为 OpenClaw 或 SDK 会自己在后面拼接 /chat/completions、/models 这些路径。
如果模型下拉框不自动显示,可以先手动填模型名。以这个通道为例,常见模型名是:
gpt-5.5
gpt-5.4
gpt-5.4-mini
gpt-5.3-codex
2. Hermes Agent 里添加同类模型
Hermes Agent 的思路类似:provider 选自定义 OpenAI 兼容接口,base_url 填官方普通通道,model 填具体模型名。示例配置可以理解成这样:
model:
  provider: custom
  default: gpt-5.5
  base_url: https://api.freemodel.dev/v1
  api_key: fe_oa_**************
如果要做多 Key 轮换,Key 池放在凭据池里管理;如果要做 fallback,再把 gpt-5.4、DeepSeek、讯飞等放到备用 provider。小白第一步不用急,先保证一个模型能正常回复。
3. Codex CLI 里怎么理解
Codex CLI 也可以接 OpenAI 兼容接口,关键还是三件事:接口地址、API Key、模型名。示例:
model_provider = "freemodel"
model = "gpt-5.5"

[model_providers.freemodel]
name = "freemodel"
base_url = "https://api.freemodel.dev"
wire_api = "responses"
注意 Codex 的新版 Responses 接口和传统 Chat Completions 接口不完全一样。有些工具用 /v1/chat/completions,有些工具用 /v1/responses。对小白来说,不用纠结底层接口名,先看工具要求你填的是“Base URL”还是“完整接口 URL”。大多数 OpenAI 兼容配置填 Base URL 即可。
最后再强调一次:文章、截图、群聊里都不要放完整 API Key;如果截图里出现了自己的加速通道或 VIP 通道,发布前要打码,演示统一换成官方普通通道。
六、低端模型逻辑跟不上时,提示词要写得更像“工单”
很多免费模型、小参数模型、本地量化模型,并不是完全不能用,而是你不能像对强模型那样随便一句“帮我处理一下”。强模型会自己补全上下文,低端模型经常补错。
所以给低端模型或便宜模型安排任务时,提示词要更像工单:目标、输入、步骤、限制、输出格式都写清楚。
不推荐的说法
帮我优化一下这个 Agent 配置,顺便看看哪里有问题。
这句话太空。强模型可能能猜到你要什么,低端模型很容易开始泛泛而谈。
推荐的说法
你是一个配置检查助手。请只做以下事情:
1. 检查这份 Hermes Agent 模型配置里是否包含主模型、base_url、api_key、fallback_providers。
2. 不要改动配置,只列出发现的问题。
3. 每个问题按“问题 / 影响 / 建议修改”三段输出。
4. 如果信息不足,直接写“缺少的信息”,不要猜。
5. 输出中文,控制在 500 字以内。
这种写法对低端模型友好很多。因为你把“思考范围”框住了,它不需要猜你的真实意图。
七、给 Agent 下任务的通用模板
如果你准备让 Agent 真正干活,而不是聊天,我建议直接收藏下面这个模板。无论你用 Hermes、Claude Code、Codex CLI、OpenCode,思路都差不多。
任务:我要你完成什么?
背景:当前系统/项目/设备是什么情况?
输入:你可以读取哪些文件、链接、日志、配置?
限制:哪些事情不能做?比如不要删除数据、不要直接重启生产服务。
步骤:先检查什么,再修改什么,最后验证什么。
输出:最后用什么格式回复?需要列出文件路径、命令结果、URL 吗?
验证:完成后必须怎么确认成功?比如 curl 返回 200、测试通过、页面能打开。
举个更接近实战的例子:
任务:帮我给 Hermes Agent 增加备用模型路由。
背景:当前主模型是 freemodel/gpt-5.5,经常遇到免费额度限流。
要求:
1. 先检查当前配置文件,不要直接覆盖。
2. 给同一个 provider 增加 2 个备用 API Key。
3. 再添加 fallback:gpt-5.4、DeepSeek、讯飞。
4. API Key 不要在最终回复里完整展示。
5. 修改前备份配置文件。
6. 修改后用 hermes config check 和一次最小对话测试验证。
输出:最后告诉我改了哪些位置、验证结果、备份文件路径。
你看,这种提示词不是“会不会写作文”的问题,而是给 Agent 一个清晰的施工单。低端模型虽然逻辑弱一点,但只要任务边界够清楚,也能处理不少简单工作。
八、本地模型要不要接进来?可以,但别硬撑
很多人喜欢“本地模型免费”这个概念,但要讲实话:本地模型免费的是 token,不免费的是硬件、功耗、折腾时间和速度。
如果你手上是 N100 小主机、RK3399、A7Z、树莓派、OpenWrt 路由器这类设备,本地模型可以做一些轻任务,但不要指望它完全替代强在线模型。
- 7B/8B 量化模型:适合简单总结、分类、短文本改写。
- 14B 量化模型:需要更大内存,速度也要看设备。
- 30B/70B:小白低配设备不建议硬上,体验很可能不好。
- 路由器:更适合做状态采集、文件服务、轻量脚本,不适合当主力推理机。
我更推荐的混合方案是:本地模型负责“不怕慢、不怕笨、可重复”的任务;在线模型负责“要理解复杂上下文、要工具调用稳定、要结果质量”的任务。
九、什么时候需要几个模型路由?
给小白一个直接建议:
- 刚开始:1 个能用的模型就够。
- 开始写文章、查资料、做自动化:1 个主模型 + 2 个备用 Key。
- 接 Telegram/QQBot 长期在线:主模型 3 Key + 1 个备用供应商。
- 要管服务器、改代码、发 WordPress:主模型 3 Key + 2 个 fallback + 本地模型补位。
- 团队或生产环境:再考虑按任务拆分专用模型,比如写作、代码、搜索、视觉、总结分别走不同模型。
不要为了“看起来专业”堆很多模型。真正好用的路由,一定是能解释清楚每个模型为什么存在。
十、我的建议:先跑起来,再逐步加保险
如果你今天刚开始搭 Agent,我建议你按这个路线走:
- 先找一个 OpenAI 兼容 API,填进 Hermes,让 Agent 能正常回复。
- 让它完成一个小任务,比如检查网站、写一段文章、读取一个文件。
- 确认工具调用没问题后,再加第二个 Key。
- 等你真的遇到限流或超时,再加第三个 Key 和 fallback 模型。
- 最后才考虑本地模型,把简单任务分流出去。
这个顺序很重要。因为小白最怕的是一开始配置太复杂,出了问题不知道是 Key 错、URL 错、模型名错,还是 fallback 没生效。先简单跑通,再逐层加保险,才是最稳的。
延伸阅读可以继续看本站这几篇:
- 《FreeModel 免费 100 美元额度怎么用?接入 Hermes Agent 做 API 测试》
- 《AI Agent 经常遇到 API 限流怎么办?从 429、额度窗口到备用线路说清楚》
- 《API 中转压力大时怎么办?AI Agent 多线路和 fallback 配置思路》
- 《AI Agent 模型路由怎么分工?便宜模型、稳定模型、强模型不要混着用》
结语:小白玩 Agent,稳定比炫技重要
Agent 真正好用,不是因为它接了多少模型,而是它能不能在你需要的时候稳定完成任务。免费模型、便宜 API、本地模型都能用,但要放在合适的位置。
我的实战感受是:一个能跑的主模型,是起步;两三个备用 Key,是保险;不同供应商 fallback,是兜底;本地模型,是长期省钱的补充。
下一篇我准备继续把这个方向写细一点:Hermes Agent 里如何把“写文章、查资料、代码修改、服务器巡检”拆成不同任务,让不同模型各干各的活。
基于实际搭建和 API fallback 使用过程整理。by 数码罗记 · godsun.pro
One thought on “免费 API 额度低怎么办?用 Hermes Agent 实战多模型路由和备用 Key”