这篇继续围绕 Claude Code 展开,主题是「Claude Code 接 MCP 有什么用?让 AI 编程助手真正能查外部工具」。前面几篇已经讲过安装、settings.json、-p 模式和 CLAUDE.md,这次往真实使用流程里再拆细一点。
MCP 是什么
MCP 全称是 Model Context Protocol,可以理解成「让大模型调外部工具的一套统一协议」。Claude Code 自己只会读写文件、跑命令,但接上 MCP 之后,它还能:
- 调 GitHub 的 API 查 PR
- 连数据库执行 SQL 查询
- 控制一个浏览器实例打开网页
- 调内部团队的 API、日志系统、监控系统
本质上,MCP 让 Claude Code 从「会写代码的助手」变成「能联网做事的助手」。
没接 MCP 之前的痛点
小白会有这样的感受:
- 让它修一个 Bug,它需要看日志,但它只能让你「复制粘贴日志给它」
- 让它做一个数据库改动,它写出 SQL 但跑不了
- 让它处理 GitHub issue,只能你自己去开页面复制内容
这些痛点本质上是「信息隔离」。MCP 解决的就是这个信息流通问题。
常见的 MCP 服务
社区里能找到的 MCP 服务不少,下面几种最实用(具体能力请以官方文档为准):
1. GitHub MCP
用于查 issue、PR、commit、文件。让 Claude Code 直接读 GitHub 上下文,而不是让你来回复制。
2. 数据库 MCP(如 Postgres)
让模型可以查 schema、读数据。强烈建议给只读权限,不要让模型直接写库。
3. 浏览器 MCP(如 Playwright)
让模型能打开网页、截图、点击。适合写爬虫、调试前端、做 E2E 测试。
4. 文件系统 MCP
给 Claude Code 一个受控的本地目录访问,常用于安全沙箱。
5. 自定义内部 MCP
如果你公司有内部 API,可以包成 MCP,让 AI 直接调你们的系统。
配置思路
MCP 通常通过一个配置文件来注册服务,大致结构是:
{
  "mcpServers": {
    "github": {
      "command": "npx",
      "args": ["-y", "@modelcontextprotocol/server-github"],
      "env": {
        "GITHUB_TOKEN": "..."
      }
    }
  }
}
(具体字段以你使用版本的官方文档为准。)
核心思路是三件事:
- 这个 MCP 服务怎么启动
- 它需要什么凭证
- Claude Code 用什么名字调用它
安全边界
MCP 是双刃剑:它让模型「能做更多事」,也意味着「能搞砸更多事」。我自己的几条习惯:
- 数据库尽量只读:能查就别写,写库走人工
- 凭证用最小权限的 token:不要给 admin token
- 生产环境单独隔离:MCP 默认不连生产
- 危险操作要二次确认:在
settings.json里把mcp__database__execute这类工具设成需要批准 - 日志要留:能看见 AI 调了什么、查了什么
适合什么场景
比较适合接 MCP 的场景:
- 项目要频繁查日志、查数据库
- 团队有现成的内部 API
- 做 E2E 测试或前端调试
- 想让 AI 处理 GitHub workflow
不一定需要 MCP 的场景:
- 纯本地脚本开发
- 完全离线的项目
- 安全要求极高,不允许 AI 接外部系统
不要被宣传带偏
要诚实说一句:接了 MCP 不等于模型一定能用好。AI 调外部工具时还是会写错参数、读错字段。所以哪怕接了 MCP,人在回路 的审查仍然不能省。
小结
MCP 是 Claude Code 走向「实际可用」的一把钥匙,但这把钥匙要配着「权限」和「日志」一起用。先想清楚要让它做什么,再决定接哪些 MCP,比一上来铺一桌子更稳。
延伸阅读
如果你还没看前面的基础篇,可以先看《Claude Code 从零搭建》《settings.json 权限配置》《CLAUDE.md 项目规则》这几篇,再回来看本文会更顺。
小结
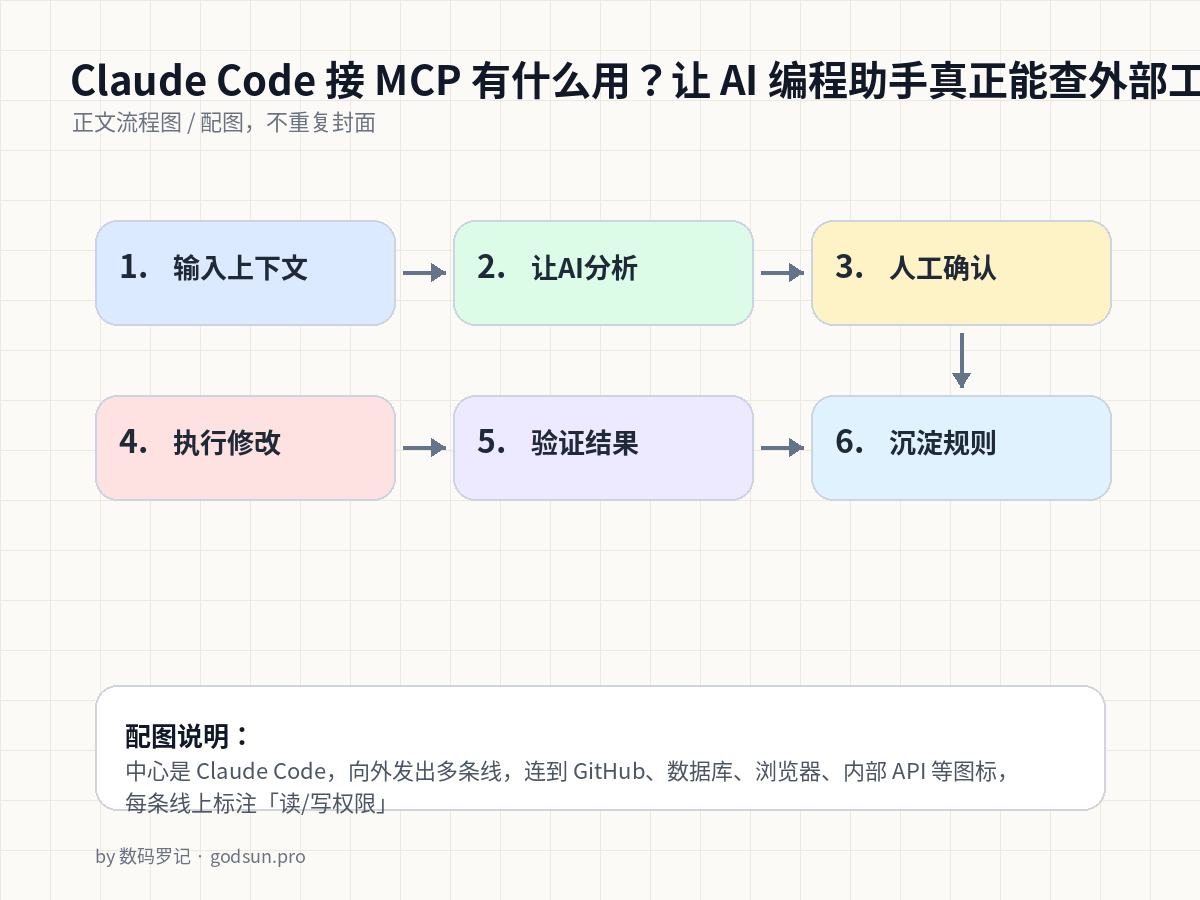
Claude Code 真正好用的地方,不是让它一次性替你完成所有事,而是把流程拆清楚:哪些让 AI 做,哪些必须人来确认,哪些结果要留下验证记录。这个习惯养成之后,它就更像一个靠谱的编程搭档。