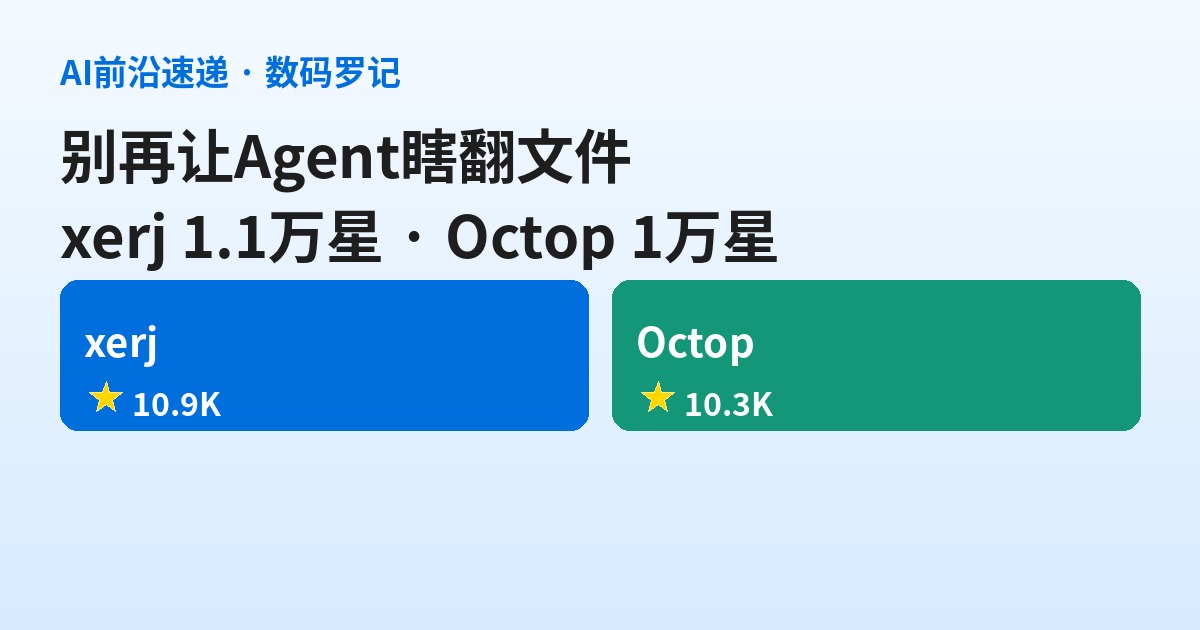
今天GitHub的AI热门榜上,两个项目都不像”模型项目”。一个把代码库做成Agent能查的索引,一个把整台机器做成一家人的AI助手。看着不性感,但都卡在Agent落地的真问题上。
xerj:让编码Agent别再拿grep翻文件
xerj 是6月30日才建仓的项目,不到四个月涨到1.09万星,Apache-2.0,Rust写的单个静态二进制。它把任意目录里的代码、文档、日志、JSONL/CSV、PDF全部索引起来,提供BM25全文、向量和混合检索,外面套一个兼容Elasticsearch的API和MCP服务。Claude Code、Cursor 这类客户端一行 xerj init 就能接上。
它最特别的用法叫 reference coding:你给Agent一个任务,它先把GitHub上最接近这个任务的开源仓库克隆下来、建索引,再让Agent去查别人怎么解的,最后才自己写。官方给的对照实验是同样16/16的解出率,输出token降到原来的1/2.7;社区里有人报日常任务能到5倍。省下来的主要是上下文——Agent不用把整个文件读进来,只拿相关片段。
装法很直接:
curl -fsSL https://xerj.org/get | sh
xerj --insecure --data-dir ./data &   # 官方 quickstart 的本地服务
xerj init
xerj autoindex ~/my-project
默认用的是离线的词法嵌入,神经嵌入要额外下约90MB模型,这项是可选。
实话:2.7倍是官方自己跑的实验,样本和任务类型都有限;reference coding 挑错仓库,等于给Agent喂一堆不相干的代码,反而更慢。索引不做增量,Agent就会拿上个月的代码回答今天的问题。它解决的是”上下文从哪来”,不是”答案对不对”。
Octop:一台机器,多个用户,一堆Agent
Octop 是腾讯云开源的自托管AI助手,1万星出头,这个月涨了6000多星。它想干的事比xerj大得多:一个进程跑起来,Web控制台、CLI、飞书、钉钉、QQ、微信、企业微信、Telegram、Discord全接进来,每个用户有自己的Agent和工作区,彼此隔离。
架构不复杂:单进程FastAPI,SQLite(WAL)或PostgreSQL存控制面状态,UserManager下面挂每个用户的HarnessAgentManager,再往下是每个Agent的AgentRuntime,配上渠道管理、定时任务和工具审批。官方把它叫”数字生命体”,这话听听就行,实际是一个把多用户、多Agent、IM入口、知识库和权限打包在一起的应用。
让我觉得实用的是这几块:
- 多用户隔离用JWT,工具调用和shell命令要审批,敏感信息出门前做脱敏;
- 工作区可以放本地盘、Docker沙箱、PostgreSQL或COS/S3,跟控制面数据库分开;
- 专家库、MBTI人格、AgentTeams(Beta)这些偏演示性质,但飞书、钉钉、QQ、微信的接入是真能省事;
- OpenAI兼容、通义DashScope、Ollama都能接,模型不用绑死一家。
装法:
curl -fsSL https://finnie-1258344699.cos.ap-guangzhou.myqcloud.com/octop/install.sh | bash
octop init
octop run
然后开 http://127.0.0.1:8088。生产环境官方推荐Docker Compose,NAS用户还有FnOS安装包。
实话:功能表长到夸张,第一次配渠道和权限会花不少时间;JWT隔离是应用层的用户隔离,不是 OpenShell 那种内核级沙箱,真要让Agent跑不受信任的代码,还是得靠Docker工作区兜底。单进程适合家用、小团队和一台闲置服务器,别拿它当公网多租户SaaS。另外它跟腾讯元器是两条路:元器把Agent放在微信生态里,Octop把整个助手搬回你自己的机器。
最后
xerj 补的是检索,Octop 补的是账号、入口和权限。两件事都不酷,但Agent真到日常使用,卡住人的往往就是这些:要么它找不到该看的代码,要么你不敢让一家人共用一个没有边界的助手。
模型能力已经过剩了,接下来一年的开源热点,大概率还会是这种”给Agent补基础设施”的活。