过去两年我把 ai.godsun.pro 上的 Agent 平台基本写了个遍:Dify、CrewAI、MetaGPT、Langflow、n8n、AutoGen……写到最后发现一个问题——这些平台全都在卷「谁来编排」,没人卷「数据在哪」。
于是这期来点不一样的。
一个 8 年前就开始跑偏的团队
MindsDB 2018 年 8 月在伯克利成立,创始人叫 Jorge Torres 和 Adam Carrigan。名字来自 Iain M. Banks 的《文化》系列——里面的「Minds」是和人并肩干活的 AI,不是替代人的那种。这个基因从第一天就定了:不把数据搬到 AI 面前,而是把 AI 搬到数据面前。
放到今天看,这个选择有点反常识。主流做法是数据先抽出来、洗干净、灌进向量库,然后让模型去查。MindsDB 反着来:模型直接装进 Postgres、MySQL、MongoDB、Snowflake 里,你继续用你本来就会的 SQL 就行。没有新集群要学,没有脆弱的导出任务,也没有第二份敏感数据需要额外治理。
我当时看到这儿就想,这种姿势放到 Agent 时代会不会已经过时了——毕竟现在都在讲 Agent 自主规划、自己调工具。
它现在叫 MindsHub 了
2026 年 5 月,MindsDB 正式改名 MindsHub。注意这里有个容易搞混的点:
- MindsHub 是产品名,MindsDB 保留为公司名
- 公司、团队、投资方一个都没变,mindsdb.com 全量 302 到 mindshub.ai
- 旧的查询引擎拆出去单独留在
github.com/mindsdb/engine,继续 MIT 开源维护
改名的理由官方说得很直白:产品已经超出了「数据库」这个名字能装下的范围。现在的 MindsHub Cowork 是个 Agent 工作台,内置数据连接器、模型路由、凭证保管库、跨会话记忆,还能把产出直接发布成可分享的 URL。
开源数据我拉了实时接口核过,不编数字:
| 项目 | 数据 |
|---|---|
mindsdb/minds 主仓 |
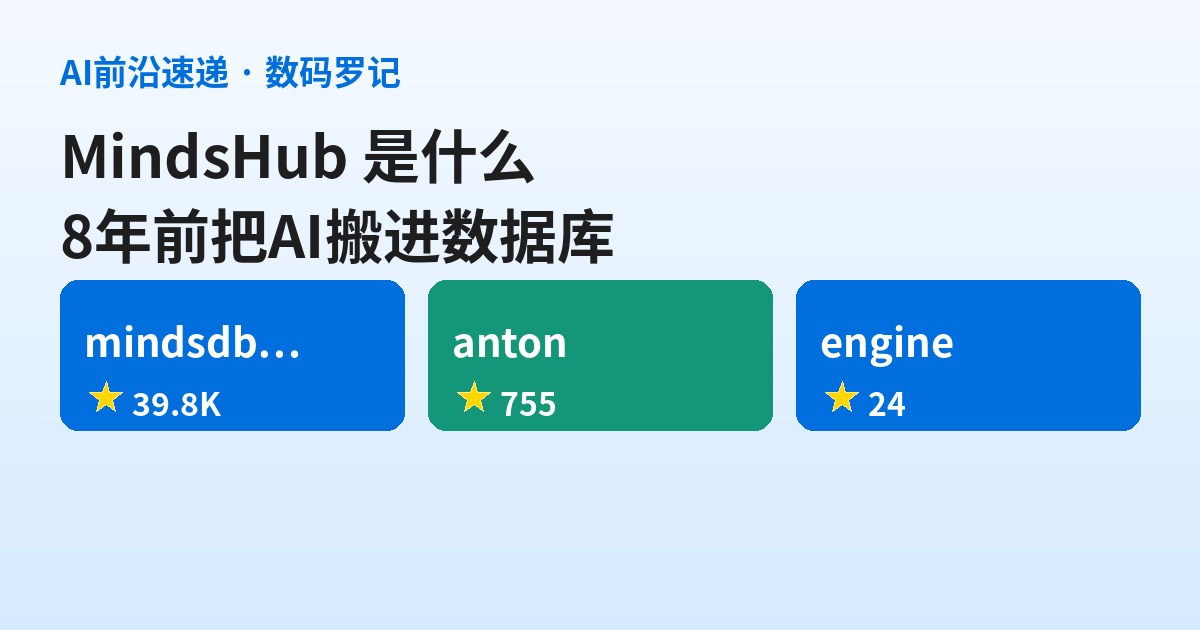
39,777 星 / 6,244 fork / MIT |
| 建仓时间 | 2018-08-02 |
mindsdb/anton |
755 星 / MIT |
mindsdb/engine 引擎仓 |
仅 24 星(2026-04 新拆) |
| 官方口径 | 50 万+ 部署、200+ 数据源、融资 $50M+ |
投资方里有 Benchmark、Mayfield、Y Combinator 和 NVIDIA。官方 about 页写 800+ 贡献者、39K+ 星。
架构:它到底怎么跑的
这张图里有三个细节值得说:
一个服务讲三种协议。 引擎同时开 HTTP 47334、MySQL 47335、PostgreSQL 47336。你的 mysql 客户端、psql、DBeaver、SQLAlchemy、BI 工具全都能直接连,不用装任何驱动适配层。
数据真的不搬家。 CREATE DATABASE 直接挂一个活的数据源进去,查询计划器把每条查询翻译成目标源的语法下推执行,结果流式返回。数据还躺在原来的 Postgres 里。
内置 MCP server。 这条在 Agent 时代很关键——官方 README 明写 MindsDB 自带 MCP server,可以让 MCP 应用直接接进来,统一回答跨库、跨仓、跨 SaaS 的问题。
上手有多快
Docker 是官方推荐路径,起完直接开 http://127.0.0.1:47334 的内置 SQL 编辑器。或者更粗暴一点,用 PyPI 装。
数据层干完了,Agent 层就是两条 SQL:
-- 1. 造个知识库,把非结构化内容灌进去
CREATE DATABASE chat_docs;
CREATE TABLE chat_docs.docs_kb (
    chunk_content TEXT,
    product_name TEXT
) ENGINE='embeddings', MODEL='openai/gpt-4o';

-- 2. 在知识库上建 Agent
CREATE AGENT support_agent USING model = {
    "provider": "openai",
    "model_name": "gpt-4o",
    "api_key": "sk-..."
}, data = {
    "knowledge_bases": ["chat_docs.docs_kb"],
    "tables": ["my_pg.products", "my_pg.users"]
}, prompt_template = 'docs_kb 存的是客服工单...';

-- 3. 用自然语言问它
SELECT answer FROM support_agent WHERE question = '最近一月退款最多的三个产品';
重点是知识库在 MindsDB 里就是一张表,检索用普通 SQL 的 WHERE 加元数据过滤,上面还能叠混合检索——向量相似度和 BM25 关键词并行跑再合并,专门对付那种「自然语言里混着产品编号」的查询。
几句实话
第一,引擎仓才 24 星,别被主仓的 4 万星骗了。 主仓 2018 年的老 star 数量和引擎仓 2026 年 4 月新拆出来的实际活跃度是两回事。看 GitHub 的时候记得看清是哪个仓。
第二,它现在更像个 Agent 平台,不太像数据工具了。 改名这件事本身就说明了问题:官方在 mindshub-vs-mindsdb 那页明确写,原查询引擎「不是 MindsHub 今天在做的产品之一」,主要靠社区维护。MindsHub 的重心转向了 Anton、模型路由这些 Agent 侧的东西。你要是冲着「在数据库里跑模型」这个老卖点去的,可能会有点找不着北。
第三,39,777 这个星数里水分不小。 一个 2018 年的项目,2026 年 9 月还有推送,但 open issues 只有 6 个、2026 年 6 月只涨了 114 星。星多不代表在活跃,这是老开源项目的通病——判断它活得怎么样,还得看 commit 频率和 issue 响应。
第四,官方口径的「50 万+ 部署」听听就好。 500K 这个量级在自托管圈子里很难交叉验证,我倾向于当成营销数字看。
适合谁? 你手上有好几个库、有 SaaS 数据、团队里 SQL 熟但 ML 不熟,那「联邦查询 + 自然语言」这条路确实省事。不适合谁? 只想调个 LLM、接个 RAG、做个聊天机器人——Dify 或 Langflow 更轻,MindsHub 这套对你就是杀鸡用牛刀。
最后
八年前「MindsDB 是给分析人员用的」,八年后它变成了一个 Agent 平台。这中间的技术其实没断——「把 AI 放到数据所在的地方」这个信念始终没变,只是执行它的东西从「数据库里的一个函数」换成了「一个会自己规划和调工具的 Agent」。
有意思的是,Agent 时代大家卷编排卷得热火朝天的时候,这个团队回头去修数据层。短期看不出什么优势,但当你的 Agent 需要在五个库和三个 SaaS 之间做联邦查询时,前面那一堆编排框架都得靠它这种底层设施。
by 数码罗记 · godsun.pro