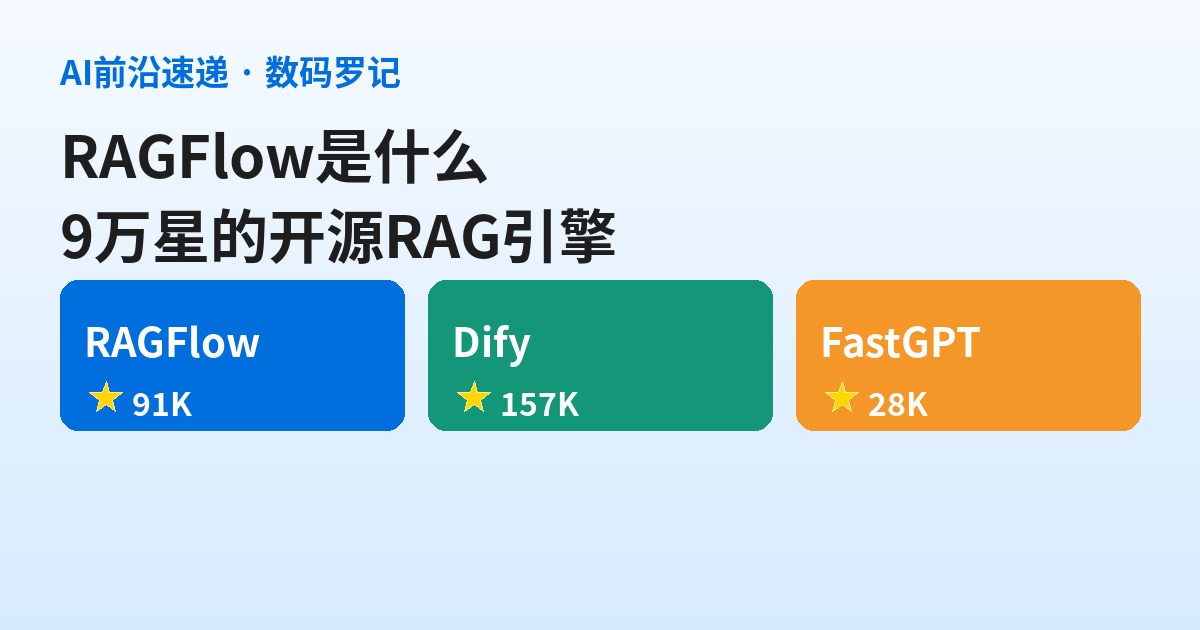
如果你玩过 Dify、FastGPT 这类 Agent 工作台,一定绕不开一个灵魂拷问:上传一堆 PDF,问两句就开始胡说八道,这知识库到底靠不靠谱?
RAGFlow 就是冲着这个问题来的。它是 InfiniFlow(infiniflow)开源的企业级 RAG 引擎,GitHub 约 9.1 万 Star、1 万多 Fork,Apache-2.0 协议。官方给自己的定位很直白:给大模型做”上下文层”——把 RAG 检索和 Agent 编排焊在一起,让你从一堆乱七八糟的文档里,直接长出一个能上线生产的问答系统。
项目介绍:不止是”检索+生成”
很多 RAG 工具本质就是”切块、向量化、检索、拼提示词”四件套。RAGFlow 不一样的地方在于三件事:
第一,深度文档理解。它自研了 DeepDoc 解析引擎,专门啃复杂版式:扫描件、影印件、带表格的 Excel、排版稀烂的 PDF 都能处理,还支持 MinerU、Docling 作为解析方式,图片内容可以用多模态大模型解析出描述。切片过程可视化,还能手动调——”Quality in, quality out”这句口号就是这么来的。
第二,答案有理有据。每个回答都带关键引用的快照,能追根溯源到原文。这是企业级场景的刚需:客服、合规、投标,谁敢用一个说不清出处的大模型?
第三,RAG 和 Agent 双驱动。2025 年 8 月之后,RAGFlow 支持了 agentic workflow 和 MCP,Agent 里还加了 Python/JS 代码执行器组件,能在流程里跑自定义逻辑。再加上 Deep Research 式的联网搜索(Tavily)、自然语言转 SQL、Agent 记忆、多聊天渠道(飞书、Discord、Telegram、Line),它已经从”知识库问答”长成了”能干活的 Agent 平台”。
数据源这块也够全:Word、PPT、Excel、TXT、图片、PDF、网页、结构化数据,外加 Confluence、S3、Notion、Google Drive 同步。对了,部署方式对个人也很友好,Docker Compose 一键起,模型随便配——OpenAI、DeepSeek、Gemini、本地 Ollama 都行。
上手:Docker 一把梭
前提条件官方写得很实在:4 核 CPU、16GB 内存、50GB 磁盘,Docker 24+、Compose v2.26.1+。只有要用代码执行器沙箱功能时才需要装 gVisor。
git clone https://github.com/infiniflow/ragflow.git
cd ragflow
docker compose -f docker/docker-compose.yml up -d
起来之后打开 Web 界面,流程基本是四步:建知识库、传文档(选解析和切片模板)、配模型、建对话助手或 Agent。想先看效果不折腾,可以直接去官网 ragflow.io 玩在线 Demo。
给新手的建议:第一次别贪多,先拿 20~50 个真实 PDF 测”大海捞针”——问几个只有文档里犄角旮旯才有的细节,看它引用的快照准不准。这一步过了,再谈 Agent 编排和上线。
说点实话
RAGFlow 的强项是”文档啃得细、回答有出处”,国产团队做企业知识库、投标文档、研报问答,选它基本不会错。但实话也有三句:
一是吃配置。16GB 内存只是起步,文档量大了之后向量库+解析模型的开销很实在,个人小鸡别硬上,本地玩玩用 Demo 或小知识库先验证。
二是它终究是 RAG 引擎,不是万能 Agent。虽然有了 Agent 编排和 MCP,但跟 n8n、Dify 那种”啥都能连”的自动化平台比,生态位不同:RAGFlow 解决的是”让 AI 说对话得有依据”,而不是”让 AI 替你跑全流程”。选型时别拿它跟 Zapier、Make 比,那是两条赛道。
三是版本迭代快,文档偶尔跟不上。遇到坑先去 GitHub Discussions 和 Discord 翻一圈,中文社区在知乎、CSDN 也有不少实战帖,比自己硬啃 issues 快。
之前写过 Dify(一套就能上线 AI 应用的开源工作流平台) 和 FastGPT(国产 RAG 实战派),可以对照看:Dify 胜在应用形态全,FastGPT 胜在开箱即用,RAGFlow 胜在文档理解深、引用可追溯。知识库准确率是你的命根子,优先试 RAGFlow。
一句话:想让 Agent 少胡说八道,先把 RAG 这层地基打牢,RAGFlow 是目前 Star 数和完成度都最能打的开源选项之一。
by 数码罗记·godsun.pro


